全球首个开源的类sora架构视频生成模型,来了!
整个训练流程,包括数据处理、所有训练细节和模型权重,全部开放。
这就是刚刚发布的Open-Sora 1.0。
它带来的实际效果如下,能生成繁华都市夜景中的车水马龙。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
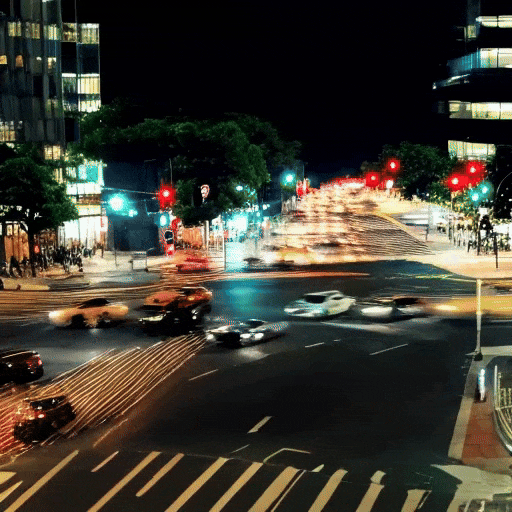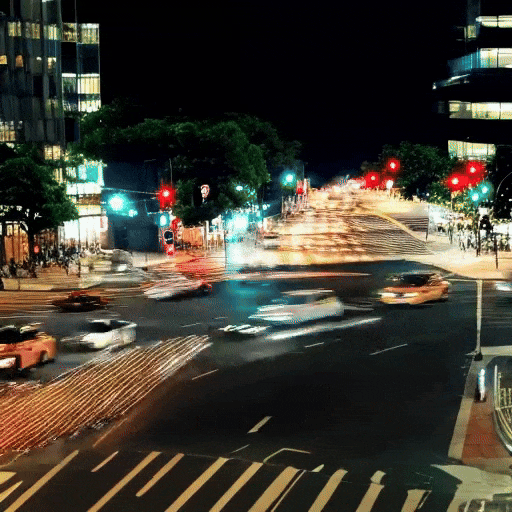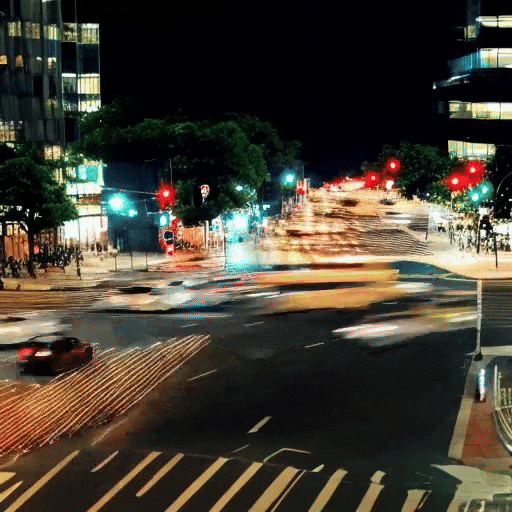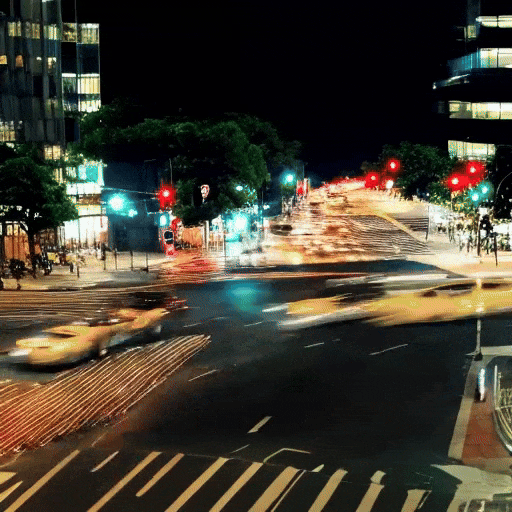
还能用航拍视角,展现悬崖海岸边,海水拍打着岩石的画面。
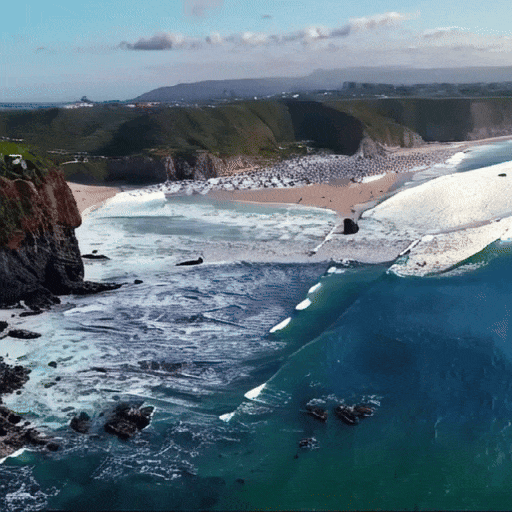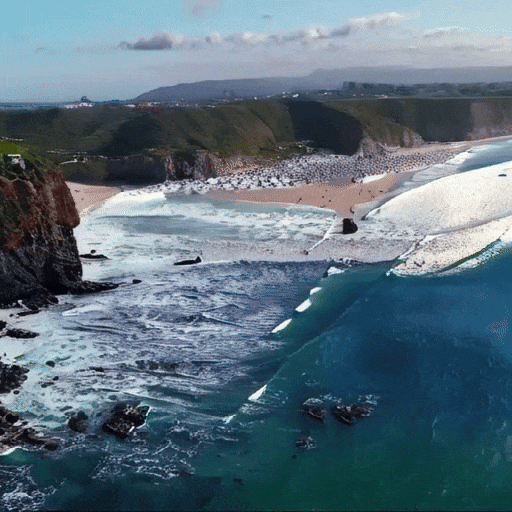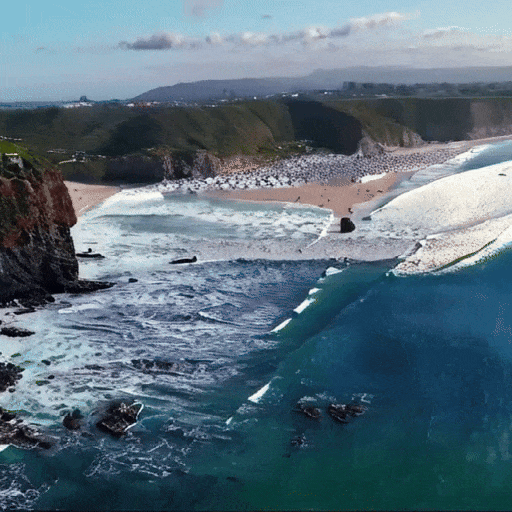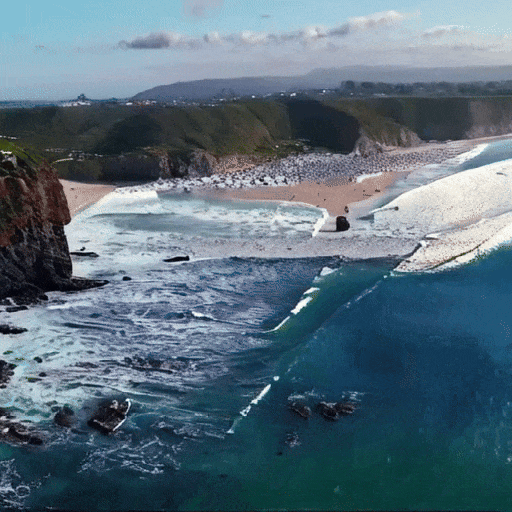
亦或是延时摄影下的浩瀚星空。
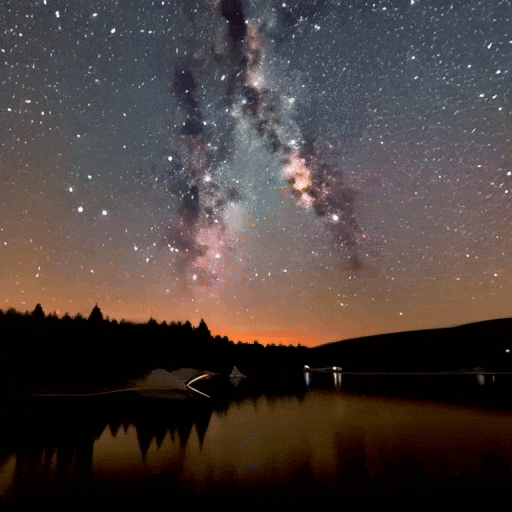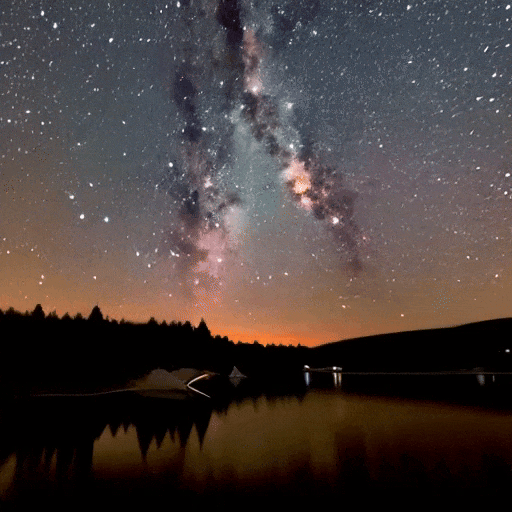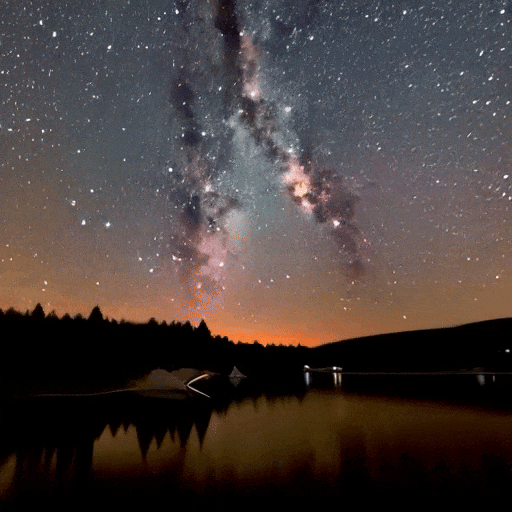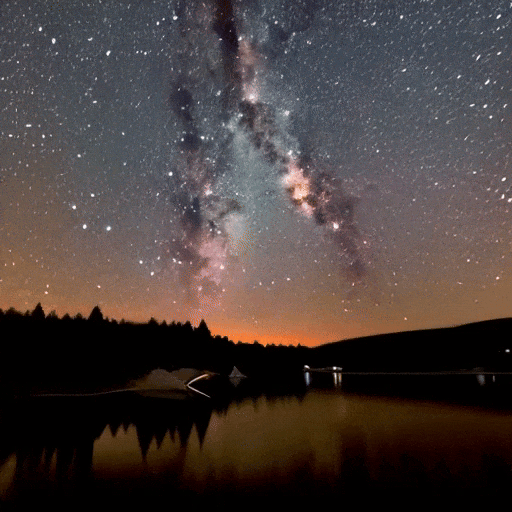
自Sora发布以来,由于其惊人的效果和技术细节的稀缺性,揭示和复现Sora已成为开发社区中最受关注的话题之一。例如,Colossal-AI团队推出了一项能够降低46%成本的Sora训练和推理复现流程。
短短两周时间后,该团队再次发布最新进展,复现类Sora方案,并将技术方案及详细上手教程在GitHub上免费开源。
那么问题来了,复现Sora如何实现?
Open-Sora 开源地址:https://github.com/hpcaitech/Open-Sora
Sora复现方案包括四个方面:
模型采用了Sora同源架构Diffusion Transformer (DiT) 。
它以采用DiT架构的高质量开源文生图模型PixArt-α为基座,在此基础上引入时间注意力层,将其扩展到视频数据上。
具体来看,整个架构包括一个预训练好的VAE,一个文本编码器和一个利用空间-时间注意力机制的STDiT (Spatial Temporal Diffusion Transformer)模型。
其中,STDiT 每层的结构如下图所示。
它采用串行的方式在二维的空间注意力模块上叠加一维的时间注意力模块,用于建模时序关系。在时间注意力模块之后,交叉注意力模块用于对齐文本的语意。
与全注意力机制相比,这样的结构大大降低了训练和推理开销。
与同样使用空间-时间注意力机制的 Latte模型相比,STDiT 可以更好的利用已经预训练好的图像 DiT 的权重,从而在视频数据上继续训练。
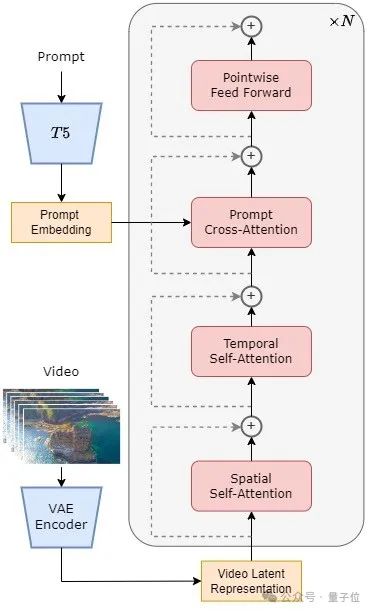
△STDiT结构示意图
整个模型的训练和推理流程如下。
据了解,在训练阶段首先采用预训练好的Variational Autoencoder (VAE)的编码器将视频数据进行压缩,然后在压缩之后的潜在空间中与文本嵌入(text embedding)一起训练STDiT扩散模型。
在推理阶段,从VAE的潜在空间中随机采样出一个高斯噪声,与提示词嵌入(prompt embedding)一起输入到STDiT中,得到去噪之后的特征,最后输入到VAE的解码器,解码得到视频。
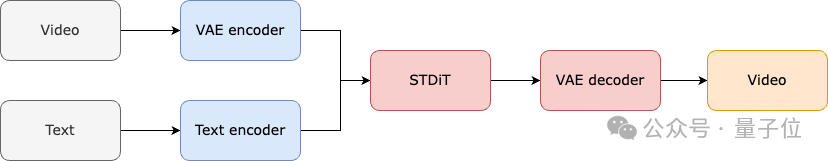
△模型训练流程
在训练复现部分,Open-Sora参考了Stable Video Diffusion (SVD)。
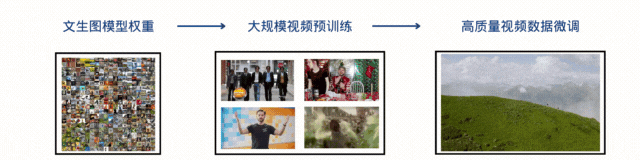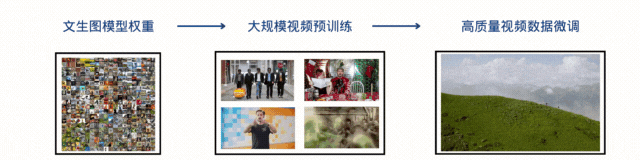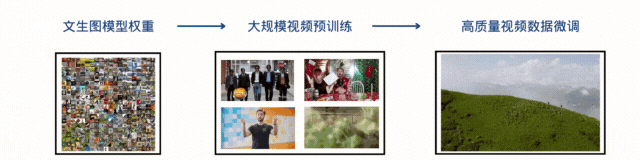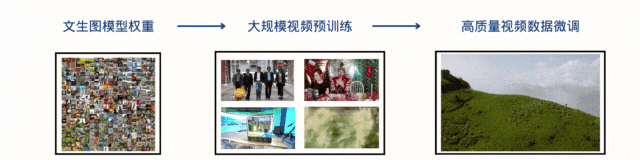
一共分为3个阶段:
每个阶段都会基 于前一个阶段的权重继续训练。
相比于从零开始单阶段训练,多阶段训练通过逐步扩展数据,更高效地达成高质量视频生成的目标。
△训练方案三阶段
团队利用互联网上丰富的图像数据和文生图技术,先训练出一个高质量的文生图模型,将该模型作为下一阶段视频预训练的初始化权重。
同时,由于目前没有高质量的时空VAE,他们采用Stable Diffusion预训练好的图像VAE。
这样不仅能保障初始模型的优越性能,还能显著降低视频预训练的整体成本。
这一阶段主要增加模型的泛化能力,有效掌握视频的时间序列关联。
它需要使用大量视频数据训练,并且保障视频素材的多样性。
同时,第二阶段的模型在第一阶段文生图模型的基础上加入了时序注意力模块,用于学习视频中的时序关系。其余模块与第一阶段保持一致,并加载第一阶段权重作为初始化,同时初始化时序注意力模块输出为零,以达到更高效更快速的收敛。
 SCISPACE
AI论文研究助手,探索和解释论文的平台
 65
查看详情

Colossal-AI团队使用了PixArt-alpha的开源权重作为第二阶段STDiT模型的初始化,以及采用了T5模型作为文本编码器。他们采用了256x256的小分辨率进行预训练,进一步增加了收敛速度,降低训练成本。
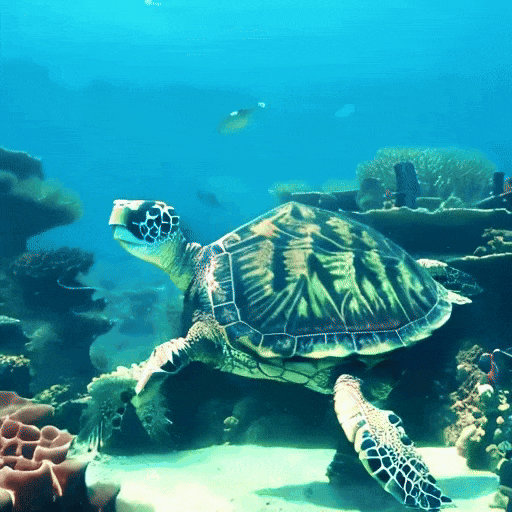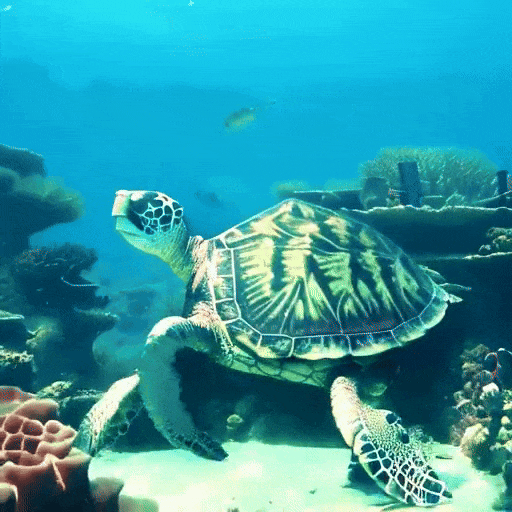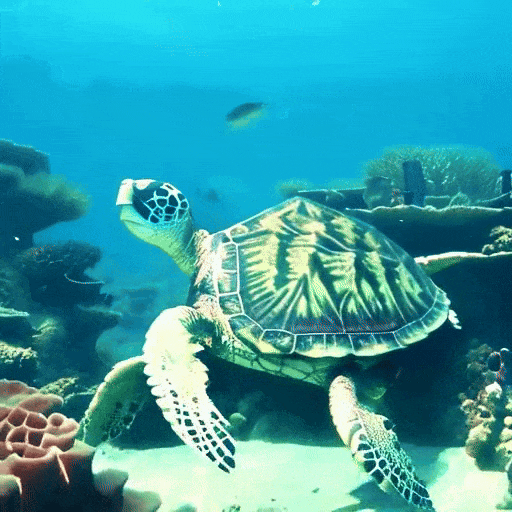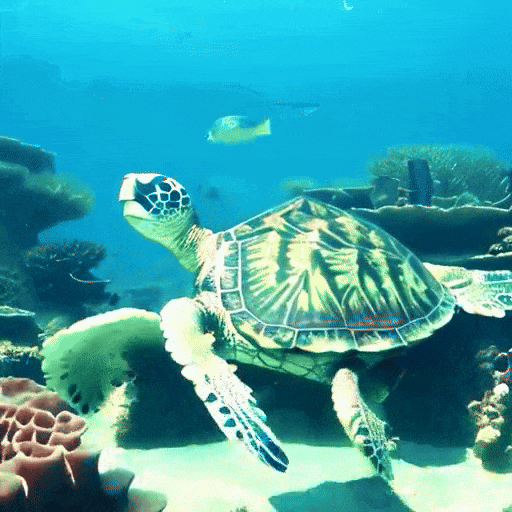
△Open-Sora生成效果(提示词:水中世界的镜头,镜头中一只海龟在珊瑚礁间悠然游弋)
据介绍,这一阶段能显著提升模型的生成质量。使用的数据规模比上一阶段降低一个量级,但是视频的时长、分辨率和质量都更高。
通过这种方式进行微调,能实现视频生成从短到长、从低分辨率到高分辨率、从低保真度到高保真度的高效扩展。
值得一提的是,Colossal-AI还详细透露了每阶段的资源使用情况。
在Open-Sora的复现流程中,他们使用了64块H800进行训练。第二阶段的训练量一共是 2808 GPU hours,约合7000美元,第三阶段的训练量是1920 GPU hours,大约4500美元。经过初步估算,整个训练方案成功把Open-Sora复现流程控制在了1万美元左右。
为了进一步降低Sora复现的门槛和复杂度,Colossal-AI团队在代码仓库中还提供了便捷的视频数据预处理脚本,让大家可以轻松启动Sora复现预训练。
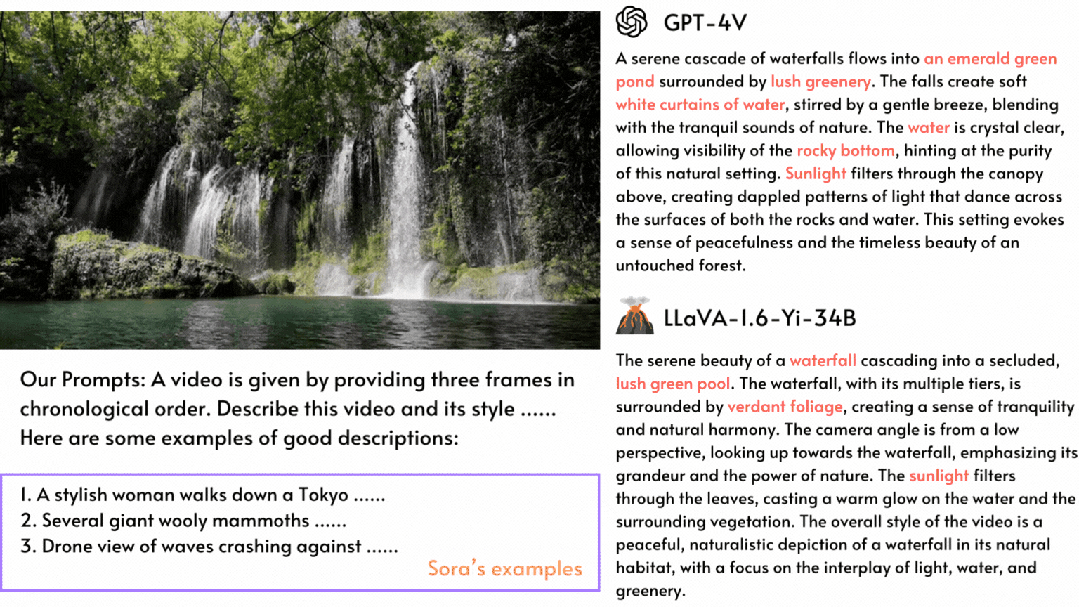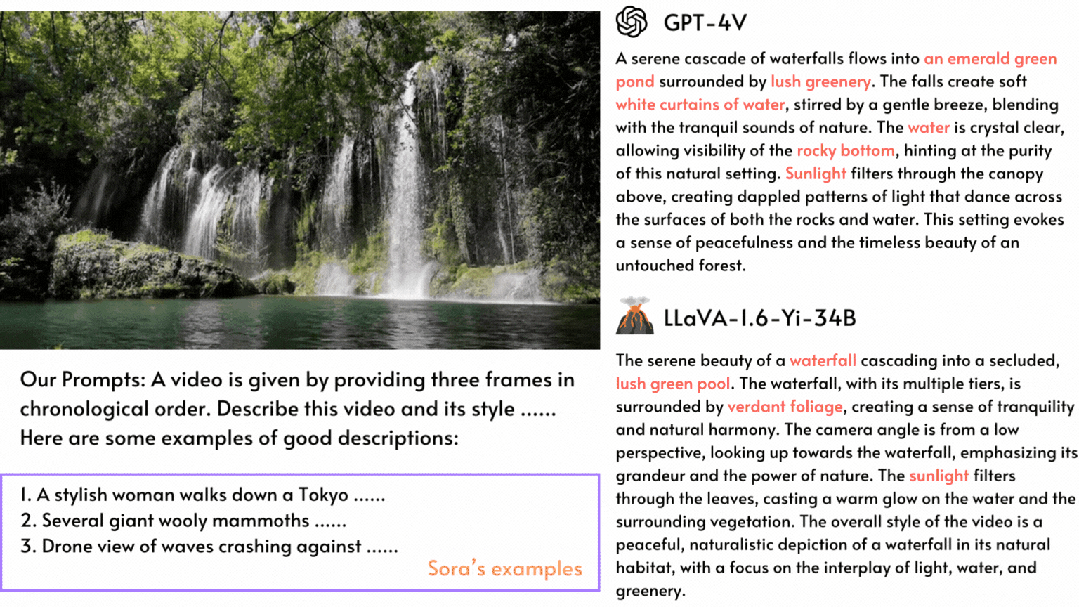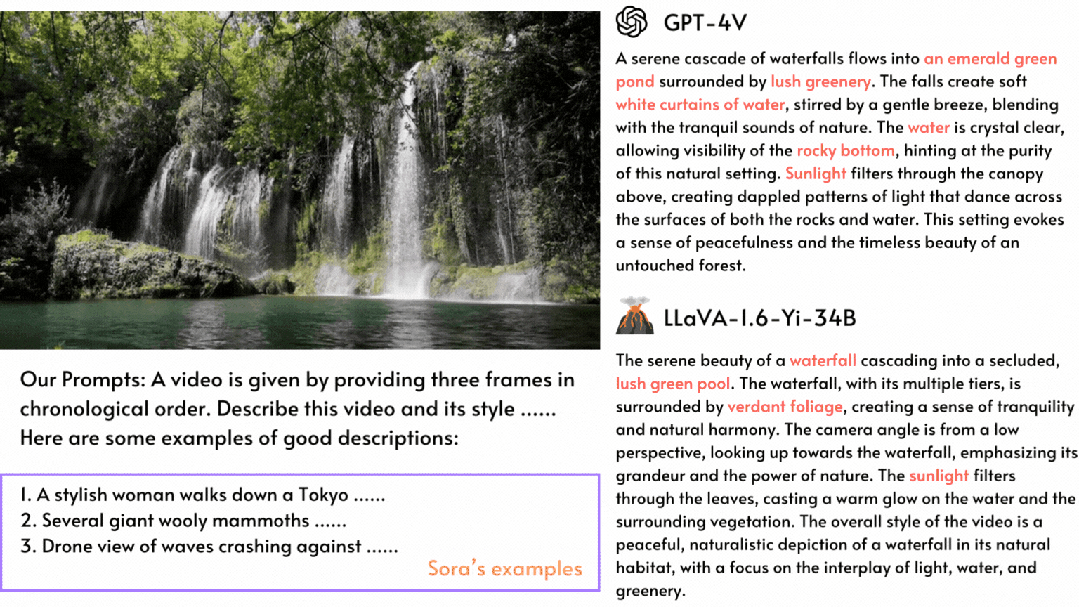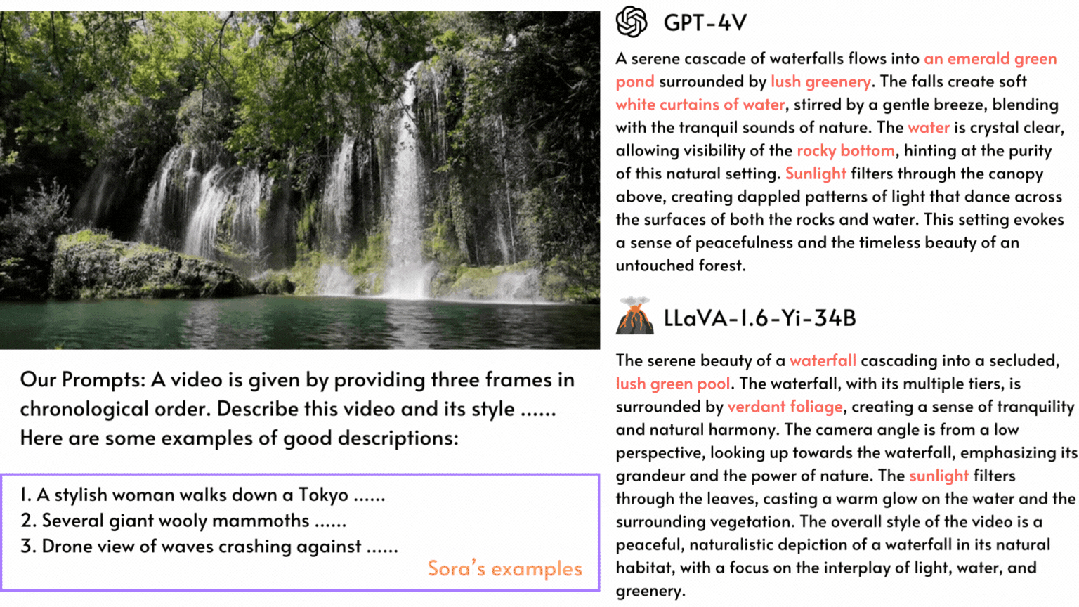
包括公开视频数据集下载、长视频根据镜头连续性分割为短视频片段、使用开源大语言模型LLaVA生成精细的提示词。
他们提供的批量视频标题生成代码可以用两卡 3 秒标注一个视频,并且质量接近于 GPT-4V。
最终得到的视频/文本对可直接用于训练。借助他们在GitHub上提供的开源代码,可以轻松地在自己的数据集上快速生成训练所需的视频/文本对,显著降低了启动Sora复现项目的技术门槛和前期准备。
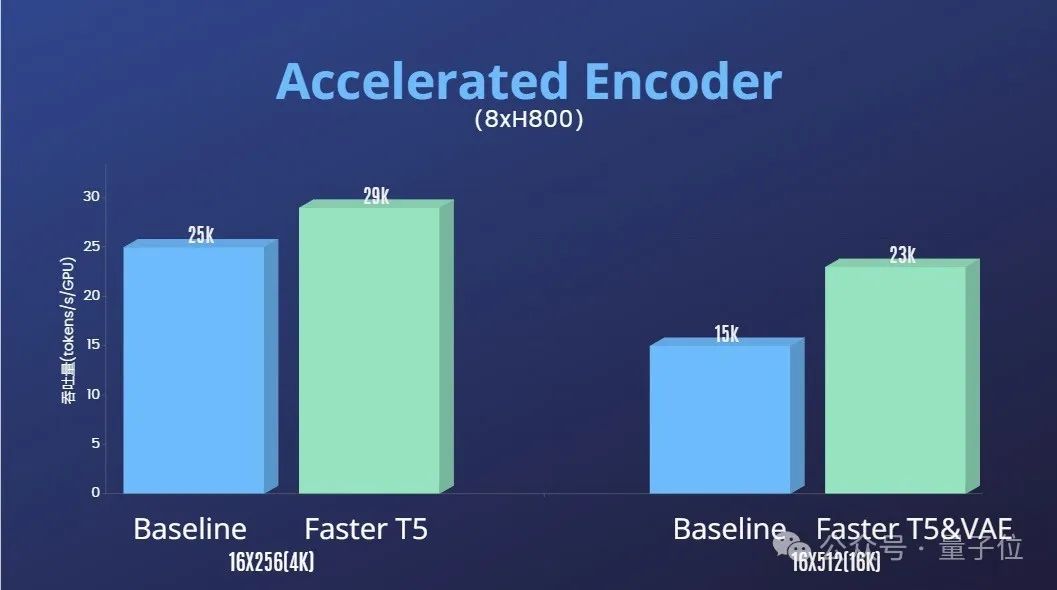
除此之外,Colossal-AI团队还提供了训练加速方案。
通过算子优化和混合并行等高效训练策略,在处理64帧、512x512分辨率视频的训练中,实现了1.55倍的加速效果。
同时,得益于Colossal-AI的异构内存管理系统,在单台服务器上(8H800)可以无阻碍地进行1分钟的1080p高清视频训练任务。
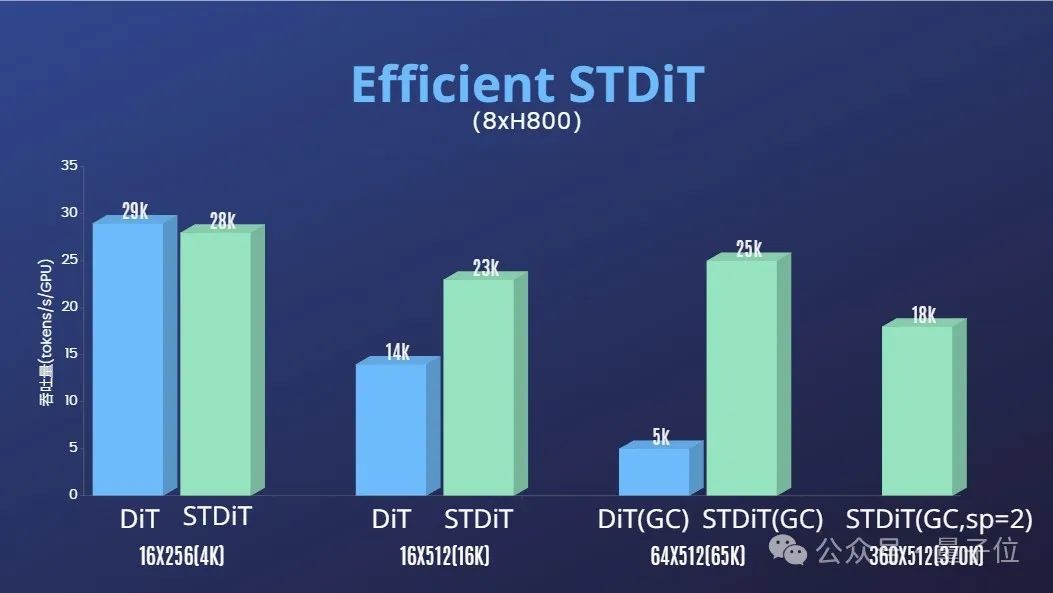
而且团队还发现STDiT模型架构在训练时也展现出卓越的高效性。
和采用全注意力机制的DiT相比,随着帧数的增加,STDiT实现了高达5倍的加速效果,这在处理长视频序列等现实任务中尤为关键。
最后,团队还放出了更多Open-Sora的生成效果。
,时长00:25
团队和量子位透露,他们将长期更新优化Open-Sora的相关解决方案和动态。未来将使用更多视频训练数据,以生成更高质量、更长时长的视频内容,并支持多分辨率特性。
实际应用方面,团队透露将推进在电影、游戏、广告等领域落地。
感兴趣的开发者们,可访问GitHub项目了解更多~
Open-Sora 开源地址:https://github.com/hpcaitech/Open-Sora
参考链接:
[1]https://arxiv.org/abs/2212.09748 Scalable Diffusion Models with Transformers。
[2]https://arxiv.org/abs/2310.00426 PixArt-α: Fast Training of Diffusion Transformer for Photorealistic Text-to-Image Synthesis。
[3]https://arxiv.org/abs/2311.15127 Stable Video Diffusion: Scaling Latent Video Diffusion Models to Large Datasets。
[4]https://arxiv.org/abs/2401.03048 Latte: Latent Diffusion Transformer for Video Generation。
[5]https://huggingface.co/stabilityai/sd-vae-ft-mse-original。
[6]https://github.com/google-research/text-to-text-transfer-transformer。
[7]https://github.com/haotian-liu/LLaVA。
[8]https://hpc-ai.com/blog/open-sora-v1.0。
以上就是全球首个类Sora开源复现方案来了!全面公开所有训练细节和模型权重的详细内容,更多请关注其它相关文章!
# 丰田
# 荥阳精英网站建设创新
# 无锡百度网站快速优化
# 天河短视频seo
# 怎么优化网站结构图片
# seo新手入门操作步骤
# 徐州seo服务方案
# 承德营销网站推广行业
# 网站建设定制价位
# 品牌推广内容营销策略有哪些
# 襄阳seo搜索
# 太多
# 时长
# 人工智能
# 这一
# 本田
# 采用了
# 高质量
# 首个
# 来了
# 开源
# latte
# stable diffusion
# stable video
# sora
# ai
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
高质量数据推动AI场景化应用快速发展及落地
创新全场景清洁方案!海尔商用机器人首发上市
稿见AI助手:提升写作效率与质量的必备工具
日媒关注中国推进鸟类识别 AI 普及,除监测保护外还可预防传染性疾病
酒店业将如何受益于人工智能的改变?
通用医疗人工智能如何革新医疗行业?
掌阅科技入选北京市通用人工智能产业创新伙伴计划第二批成员名单
盘古大模型3.0正式发布 AI开发正走向新“工业化开发模式”
调查:过半数艺术家认为 AI 作图无法帮助他们的工作
视觉中国推出AI灵感绘图功能
普林斯顿大学推出 Infinigen AI 模型,生成真实自然环境 3D 场景
郭帆:AI发展日新月异,或是弯道超车好莱坞的最好机会
三个全球首创,青岛西海岸新区“海元宇宙”亮相世界人工智能大会
海柔创新携手SAP,以机器人技术助力全球客户升级数智化竞争力
Win11 的画图应用将包含 Windows Copilot 的 AI 工具整合
十个AI算法常用库J*a版
Xreal AR 眼镜用投屏盒子 Beam 发布:分体式设计,到手 699 元
人工智能赋能无人驾驶:商业化进程再提速
OpenAI CEO 阿尔特曼到访日本,对全球 AI 协调合作表示乐观
热点资讯:家乐福推出聊天机器人;米哈游2025年营收273.4亿元…
大型无人机FH-98国内首次夜航转场成功
Meta 发布 Voicebox AI 模型:可生成音频信息,用于 NPC 对话等
普林斯顿Infinigen矩阵开启!AI造物主100%创造大自然,逼真到炸裂
Meta 人工智能业务落后竞争对手,研究人员大量离职成重要原因
美图秀秀“AI 扩图”功能上线,可根据图像生成更大画幅
两型无人机完成交付!国家级机动观测业务正式启动
令人震惊的特斯拉机器人
特斯拉机器人面世 未来将大幅提振磁材需求,引领人工智能时代
鸿蒙生态带来了哪些新的流量可能性,包括AI、服务分发和原生智能等方面?
智能机器人与话剧的完美结合:宇树四足机器人B1助力《骆驼祥子》重现经典
CharacterAI - 也许会成为会话人工智能的未来
杭州举办第19届亚运会,主题为「亚运元宇宙」的发布仪式举行
探索人工智能和物联网的动态融合
科普:什么是AI大模型
北京市通用人工智能产业创新伙伴计划名单公布,京东科技入选“算力伙伴”
数据显示:人工智能相关专业热度上升最快 考古、美术、生物医学工程等小众专业火了
一公司推出喷火机器狗,可喷出 9 米长火焰
谷歌内部正在测试代号为Genesis的AI新闻写作产品
华为4G5G通信物联网收费标准公布,多年研发成果,十年花费近万亿
阿里达摩院发布免费开放100项AI专利许可的动机是什么?
Hugging Face发布了基于NASA卫星数据构建的AI地理空间基础模型
世界人工智能大会|“AI领航,共筑未来”高端保险论坛成功举办
AI智能室内效果图设计软件效果,确实惊到我了!
大疆 DJI Mini 4 Pro 无人机曝光:流线设计,有望迎来功能性提升
抛媚眼给瞎子看?微软、谷歌的AI广告被广告主抵制
IBM将模拟计算用于人工智能,重塑AI计算
生成式AI引路产业加速来袭,微美全息探索“AIGC+虚拟人”融合应用
赋能选题探索:AI助手在经济学专业中的应用指南
2025年的网络分区:人工智能和自动化如何改变事物
自己动手使用AI技术实现数字内容生产
2024-03-18

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。
