不久前 OpenAI Sora 以其惊人的视频生成效果迅速走红,在一众文生视频模型中突出重围,成为全球瞩目的焦点。继 2 周前推出成本直降 46% 的 Sora 训练推理复现流程后,Colossal-AI 团队全面开源全球首个类 Sora 架构视频生成模型 「Open-Sora 1.0」,涵盖了整个训练流程,包括数据处理、所有训练细节和模型权重,携手全球 AI 热爱者共同推进视频创作的新纪元。
先睹为快,我们先看一段由 Colossal-AI 团队发布的「Open-Sora 1.0」模型生成的都市繁华掠*频。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
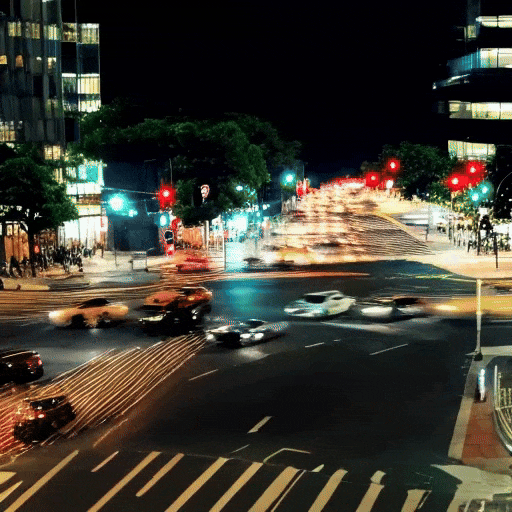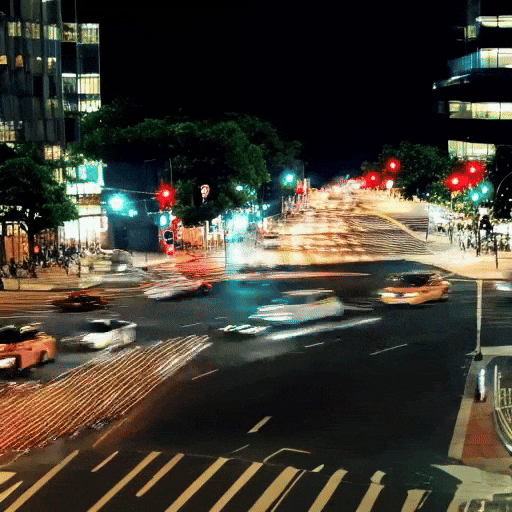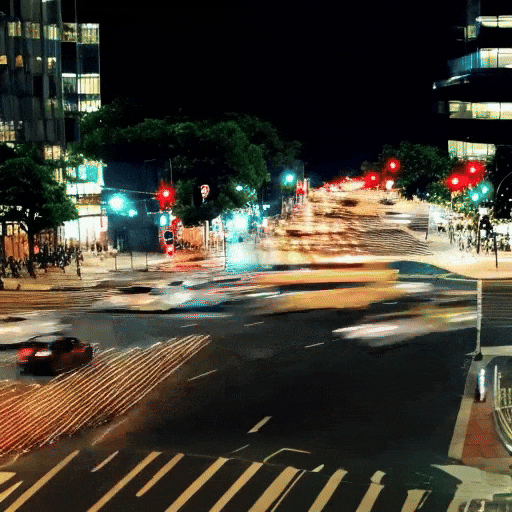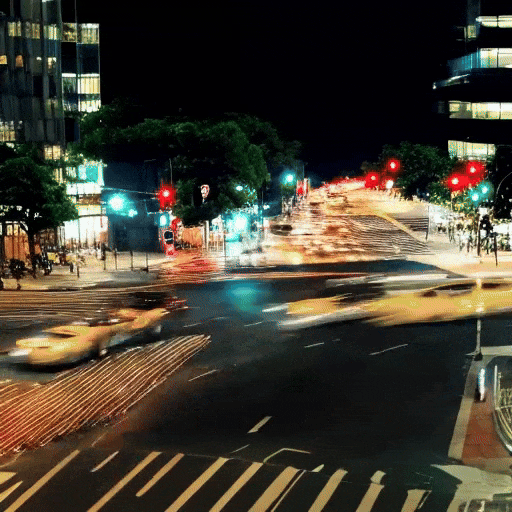
Open-Sora 1.0 生成的都市繁华掠影
这仅仅是 Sora 复现技术冰山的一角,关于以上文生视频的模型架构、训练好的模型权重、复现的所有训练细节、数据预处理过程、demo 展示和详细的上手教程,Colossal-AI 团队已经全面免费开源在 GitHub,同时笔者第一时间联系了该团队,了解到他们将不断更新 Open-Sora 的相关解决方案和最新动态,感兴趣的朋友可以持续关注 Open-Sora 的开源社区。
open-sora 开源地址:https://github.com/hpcaitech/open-sora
接下来,我们将深入探讨Sora复现方案的几个关键方面,包括模型架构设计、训练方法、数据预处理、模型效果展示以及优化训练策略。
模型采用了目前火热的 Diffusion Transformer (DiT) [1] 架构。作者团队以同样使用 DiT 架构的高质量开源文生图模型 PixArt-α [2] 为基座,在此基础上引入时间注意力层,将其扩展到了视频数据上。具体来说,整个架构包括一个预训练好的 VAE,一个文本编码器,和一个利用空间 - 时间注意力机制的 STDiT (Spatial Temporal Diffusion Transformer) 模型。其中,STDiT 每层的结构如下图所示。它采用串行的方式在二维的空间注意力模块上叠加一维的时间注意力模块,用于建模时序关系。在时间注意力模块之后,交叉注意力模块用于对齐文本的语意。与全注意力机制相比,这样的结构大大降低了训练和推理开销。与同样使用空间 - 时间注意力机制的 Latte [3] 模型相比,STDiT 可以更好的利用已经预训练好的图像 DiT 的权重,从而在视频数据上继续训练。
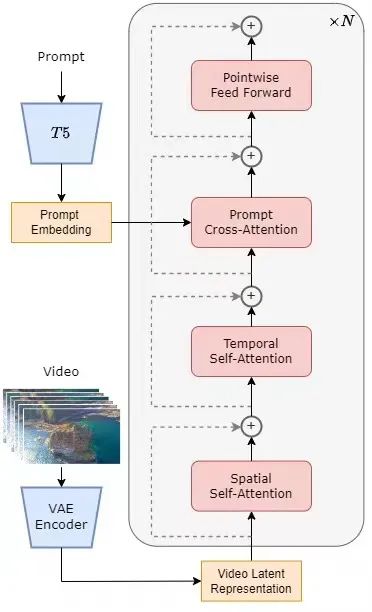
STDiT 结构示意图
整个模型的训练和推理流程如下。据了解,在训练阶段首先采用预训练好的 Variational Autoencoder (VAE) 的编码器将视频数据进行压缩,然后在压缩之后的潜在空间中与文本嵌入 (text embedding) 一起训练 STDiT 扩散模型。在推理阶段,从 VAE 的潜在空间中随机采样出一个高斯噪声,与提示词嵌入 (prompt embedding) 一起输入到 STDiT 中,得到去噪之后的特征,最后输入到 VAE 的解码器,解码得到视频。
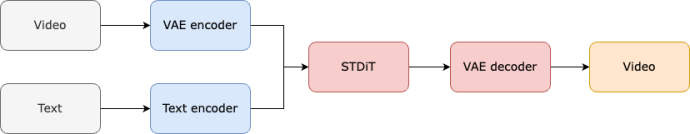
模型的训练流程
我们向该团队了解到,Open-Sora 的复现方案参考了 Stable Video Diffusion (SVD)[3] 工作,共包括三个阶段,分别是:
每个阶段都会基于前一个阶段的权重继续训练。相比于从零开始单阶段训练,多阶段训练通过逐步扩展数据,更高效地达成高质量视频生成的目标。
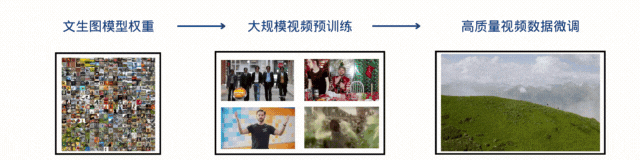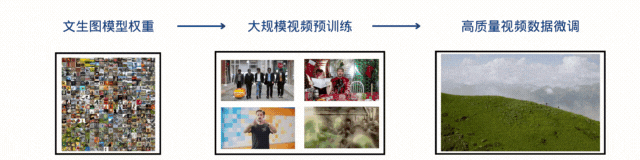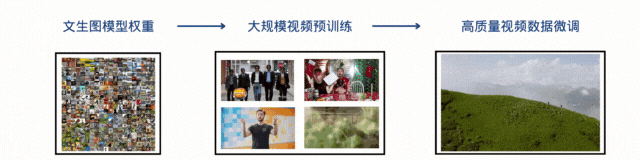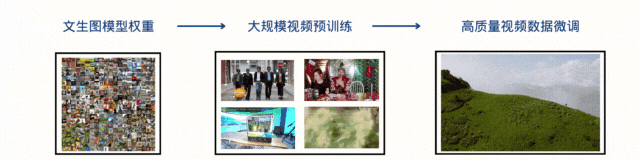
训练方案三阶段
第一阶段通过大规模图像预训练,借助成熟的文生图模型,有效降低视频预训练成本。
作者团队向我们透露,通过互联网上丰富的大规模图像数据和先进的文生图技术,我们可以训练一个高质量的文生图模型,该模型将作为下一阶段视频预训练的初始化权重。同时,由于目前没有高质量的时空 VAE,他们采用了 Stable Diffusion [5] 模型预训练好的图像 VAE。该策略不仅保障了初始模型的优越性能,还显著降低了视频预训练的整体成本。
第二阶段执行大规模视频预训练,增加模型泛化能力,有效掌握视频的时间序列关联。
我们了解到,这个阶段需要使用大量视频数据训练,保证视频题材的多样性,从而增加模型的泛化能力。第二阶段的模型在第一阶段文生图模型的基础上加入了时序注意力模块,用于学习视频中的时序关系。其余模块与第一阶段保持一致,并加载第一阶段权重作为初始化,同时初始化时序注意力模块输出为零,以达到更高效更快速的收敛。Colossal-AI 团队使用了 PixArt-alpha [2] 的开源权重作为第二阶段 STDiT 模型的初始化,以及采用了 T5 [6] 模型作为文本编码器。同时他们采用了 256x256 的小分辨率进行预训练,进一步增加了收敛速度,降低训练成本。
第三阶段对高质量视频数据进行微调,显著提升视频生成的质量。
作者团队提及第三阶段用到的视频数据规模比第二阶段要少一个量级,但是视频的时长、分辨率和质量都更高。通过这种方式进行微调,他们实现了视频生成从短到长、从低分辨率到高分辨率、从低保真度到高保真度的高效扩展。
作者团队表示,在 Open-Sora 的复现流程中,他们使用了 64 块 H800 进行训练。第二阶段的训练量一共是 2808 GPU hours,约合 7000 美元,第三阶段的训练量是 1920 GPU hours,大约 4500 美元。经过初步估算,整个训练方案成功把 Open-Sora 复现流程控制在了 1 万美元左右。
为了进一步降低 Sora 复现的门槛和复杂度,Colossal-AI 团队在代码仓库中还提供了便捷的视频数据预处理脚本,让大家可以轻松启动 Sora 复现预训练,包括公开视频数据集下载,长视频根据镜头连续性分割为短视频片段,使用开源大语言模型 LLaVA [7] 生成精细的提示词。作者团队提到他们提供的批量视频标题生成代码可以用两卡 3 秒标注一个视频,并且质量接近于 GPT-4V。最终得到的视频 / 文本对可直接用于训练。借助他们在 GitHub 上提供的开源代码,我们可以轻松地在自己的数据集上快速生成训练所需的视频 / 文本对,显著降低了启动 Sora 复现项目的技术门槛和前期准备。
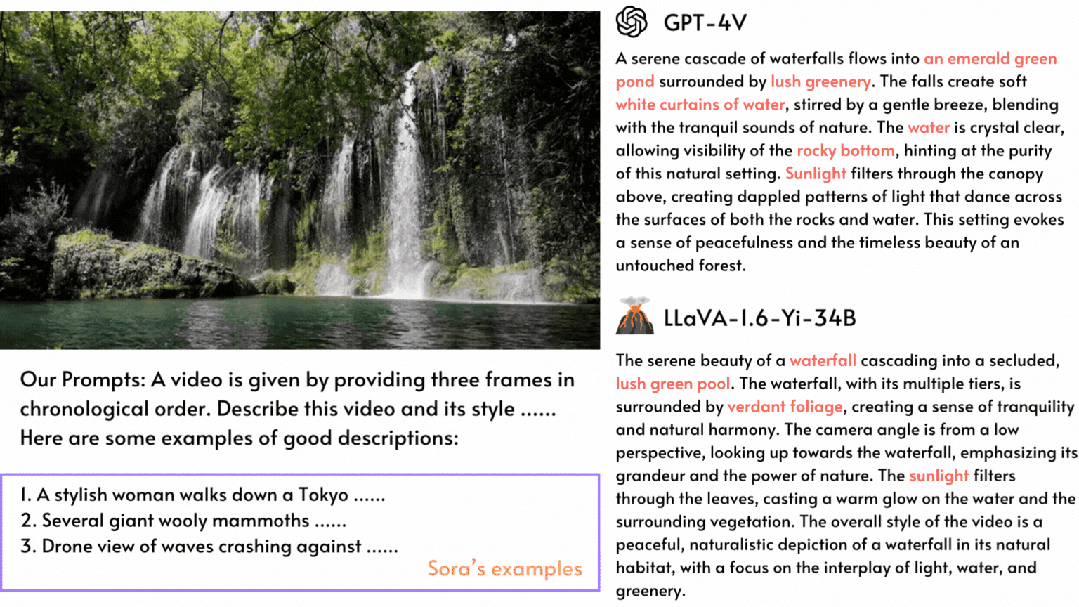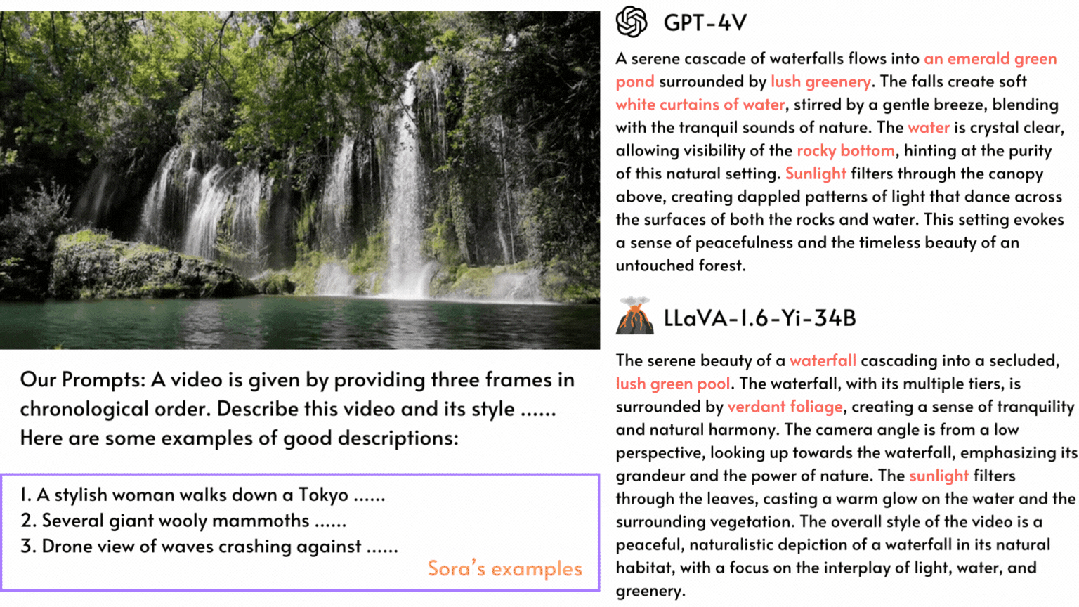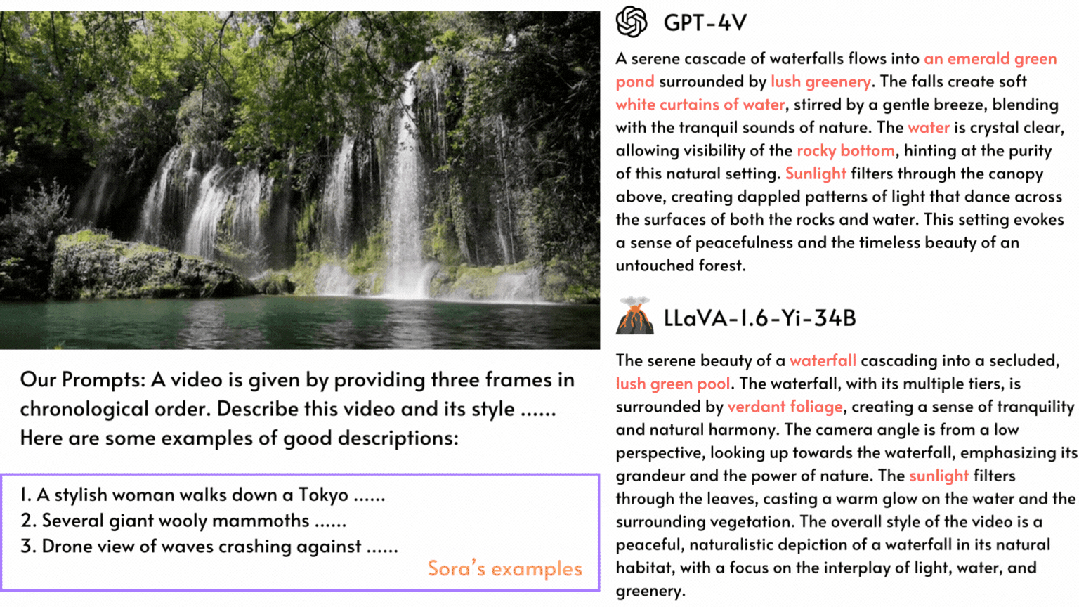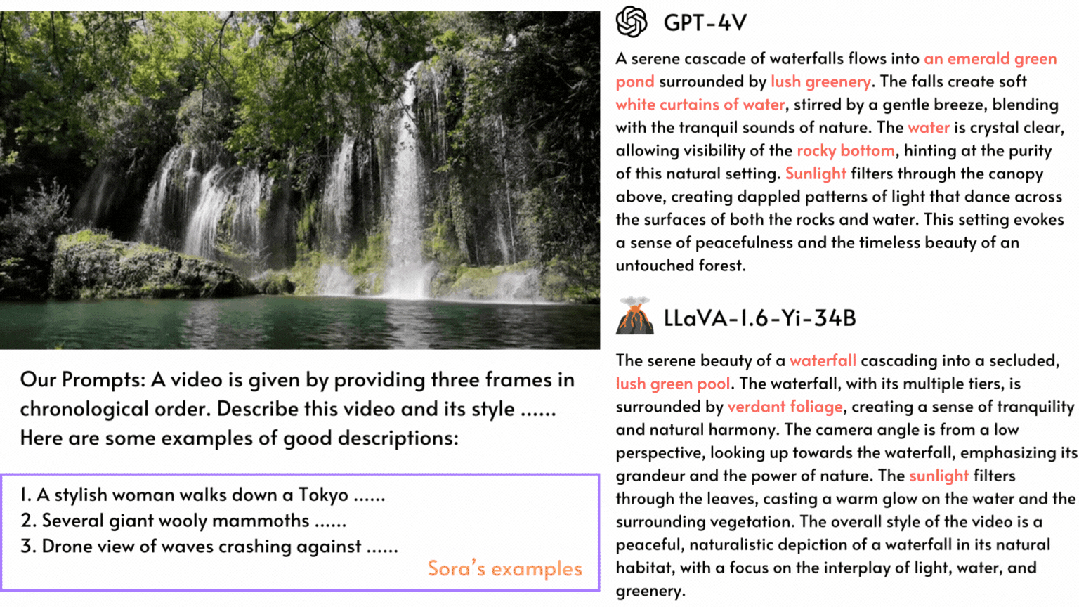
基于数据预处理脚本自动生成的视频 / 文本对
下面我们来看一下 Open-Sora 实际视频生成效果。比如让 Open-Sora 生成一段在悬崖海岸边,海水拍打着岩石的航拍画面。
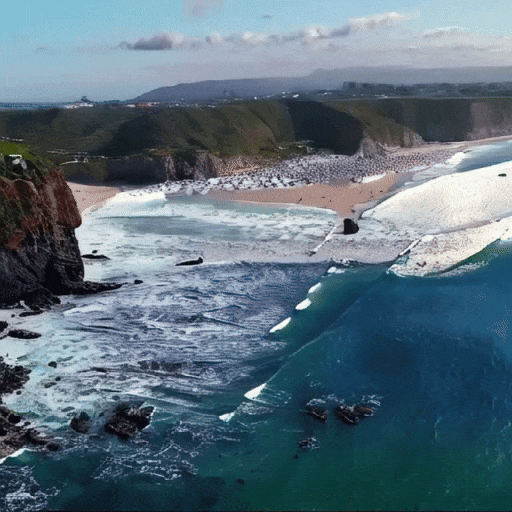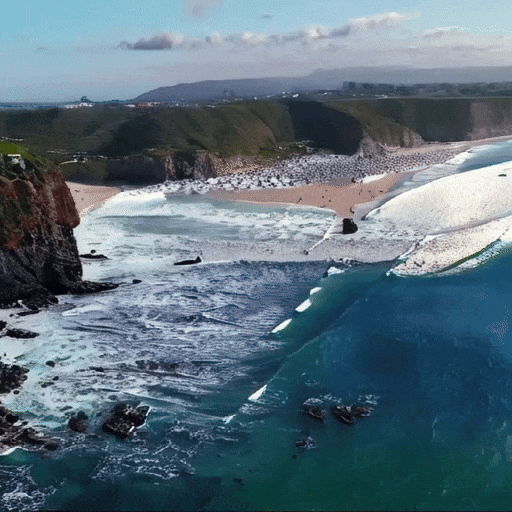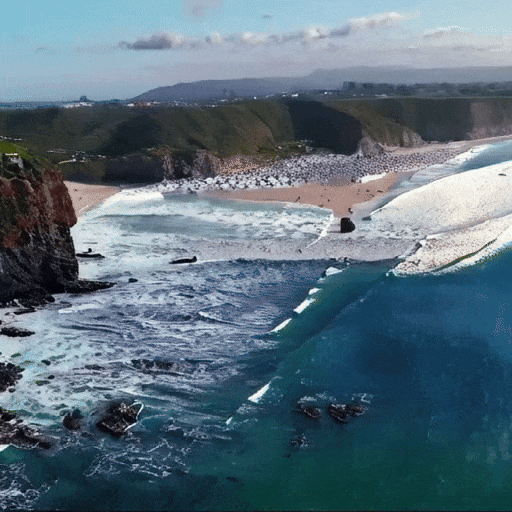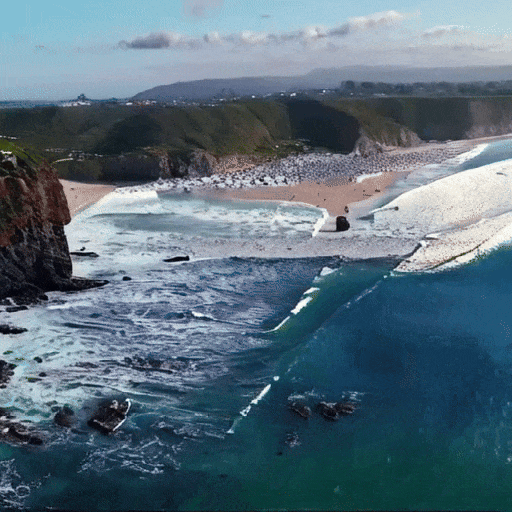
再让 Open-Sora 去捕捉山川瀑布从悬崖上澎湃而下,最终汇入湖泊的宏伟鸟瞰画面。
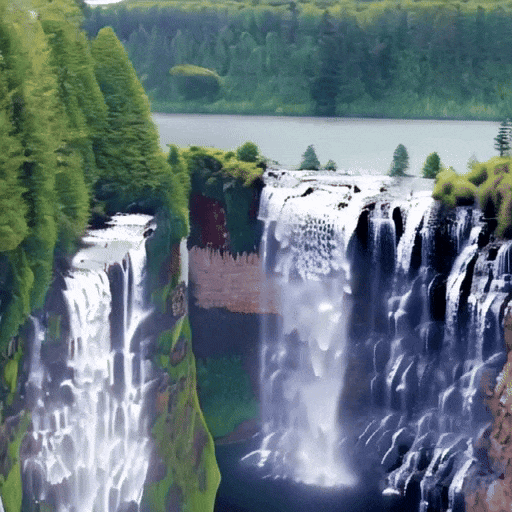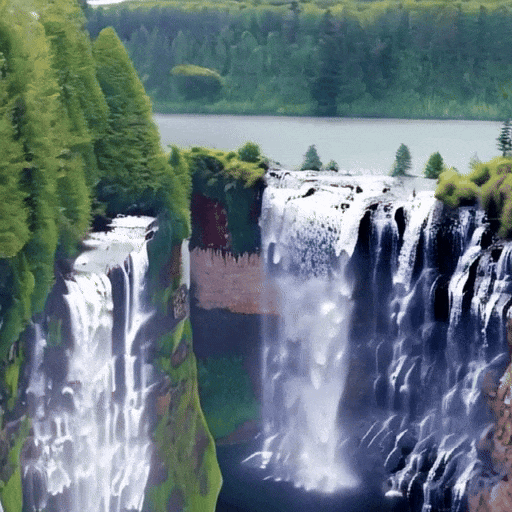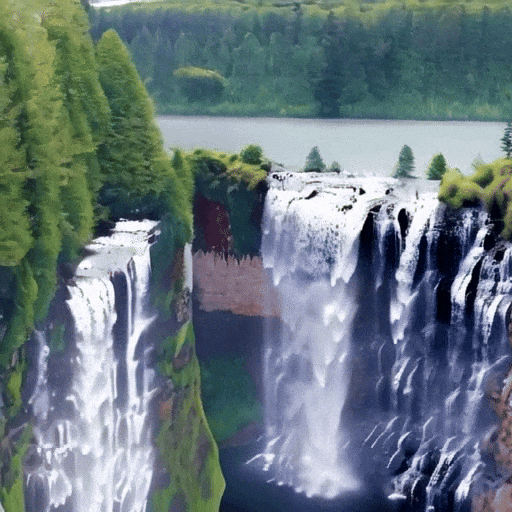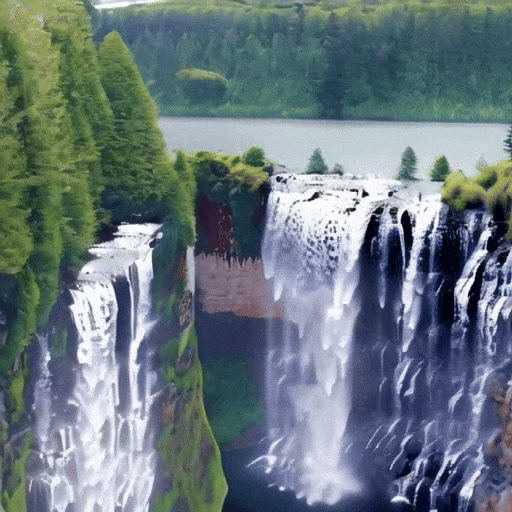
除了上天还能入海,简单输入 prompt,让 Open-Sora 生成了一段水中世界的镜头,镜头中一只海龟在珊瑚礁间悠然游弋。

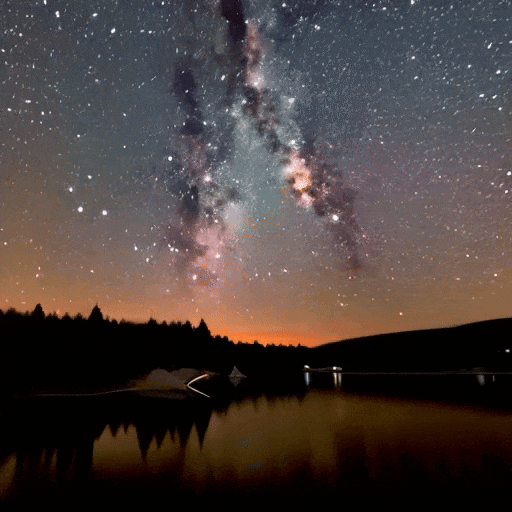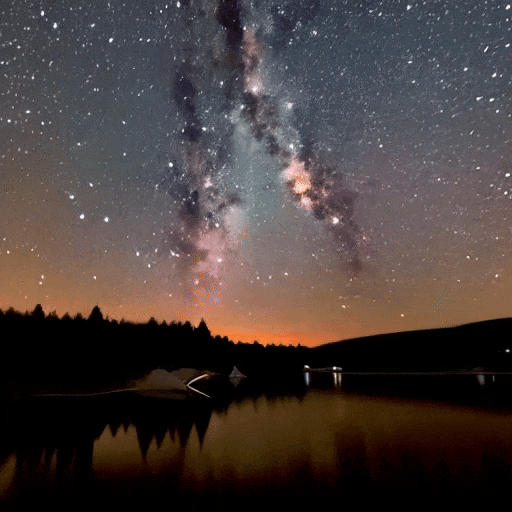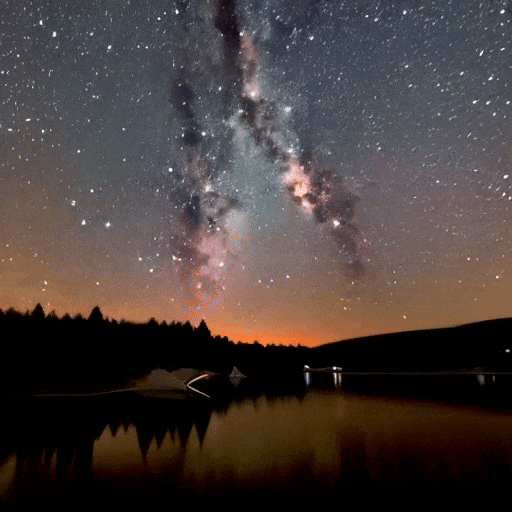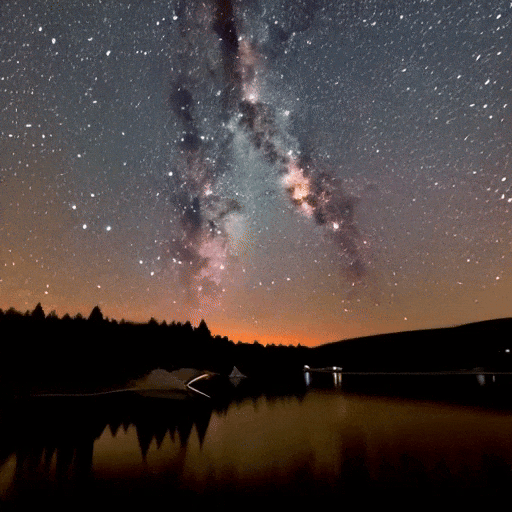
Open-Sora 还能通过延时摄影的手法,向我们展现了繁星闪烁的银河。
如果你还有更多视频生成的有趣想法,可以访问 Open-Sora 开源社区获取模型权重进行免费的体验。链接:https://github.com/hpcaitech/Open-Sora
值得注意的是,作者团队在 Github 上提到目前版本仅使用了 400K 的训练数据,模型的生成质量和遵循文本的能力都有待提升。例如在上面的乌龟视频中,生成的乌龟多了一只脚。Open-Sora 1.0 也并不擅长生|成人|像和复杂画面。作者团队在 Github 上列举了一系列待做规划,旨在不断解决现有缺陷,提升生成质量。
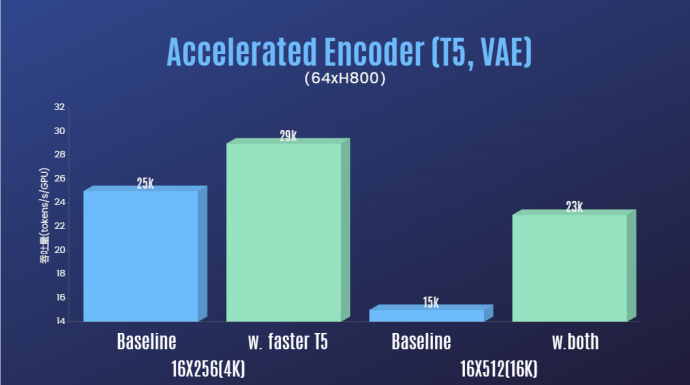
除了大幅降低 Sora 复现的技术门槛,提升视频生成在时长、分辨率、内容等多个维度的质量,作者团队还提供了 Colossal-AI 加速系统进行 Sora 复现的高效训练加持。通过算子优化和混合并行等高效训练策略,在处理 64 帧、512x512 分辨率视频的训练中,实现了 1.55 倍的加速效果。同时,得益于 Colossal-AI 的异构内存管理系统,在单台服务器上(8*H800)可以无阻碍地进行 1 分钟的 1080p 高清视频训练任务。
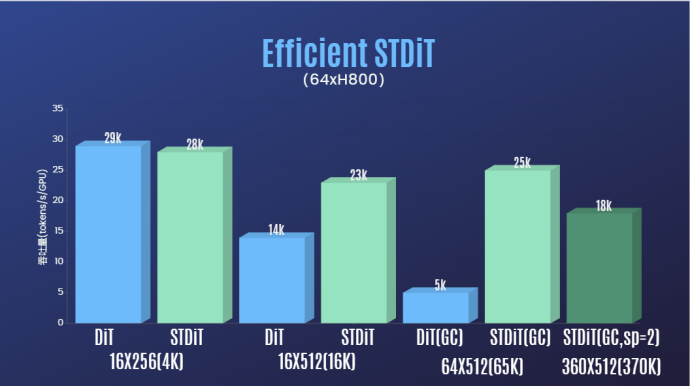
此外,在作者团队的报告中,我们也发现 STDiT 模型架构在训练时也展现出卓越的高效性。和采用全注意力机制的 DiT 相比,随着帧数的增加,STDiT 实现了高达 5 倍的加速效果,这在处理长视频序列等现实任务中尤为关键。
欢迎持续关注 Open-Sora 开源项目:https://github.com/hpcaitech/Open-Sora
 MyBB 国外最好的免费论坛
MyBB的全称是mybboard,是一个基于PHP+MySQL搭建,功能强大,高效的开源论坛系统。 MyBB 使用了标准的论坛结构和模式,所以您的用户可以在您的论坛获得良好的用户体验。用户可以通过用户控制面板来自定义他们访问论坛的方式或者自定义他们想看到的论坛的内容,他们还可以方便地发表和答复一个主题并且标记与他们有关的主题。论坛管理员和版主可以使用MyBB的内置编辑器和版主工具等功能,控制并维
 95
查看详情

作者团队表示,他们将会继续维护和优化 Open-Sora 项目,预计将使用更多的视频训练数据,以生成更高质量、更长时长的视频内容,并支持多分辨率特性,切实推进 AI 技术在电影、游戏、广告等领域的落地。
参考链接:
[1] https://arxiv.org/abs/2212.09748 Scalable Diffusion Models with Transformers。
[2] https://arxiv.org/abs/2310.00426 PixArt-α: Fast Training of Diffusion Transformer for Photorealistic Text-to-Image Synthesis。
[3] https://arxiv.org/abs/2311.15127 Stable Video Diffusion: Scaling Latent Video Diffusion Models to Large Datasets。
[4] https://arxiv.org/abs/2401.03048 Latte: Latent Diffusion Transformer for Video Generation。
[5] https://huggingface.co/stabilityai/sd-vae-ft-mse-original。
[6] https://github.com/google-research/text-to-text-transfer-transformer。
[7] https://github.com/haotian-liu/LLaVA。
[8] https://hpc-ai.com/blog/open-sora-v1.0。
以上就是没等来OpenAI,等来了Open-Sora全面开源的详细内容,更多请关注其它相关文章!
# 免费论坛
# 医疗保健网站推广策划
# 活动推广视频素材网站
# 石家庄品牌网站建设公司
# 南雄网站建设推广厂商
# 营销推广分类表怎么写好
# 龙岗网站建设培训学习班
# 广告营销和推广哪个好点
# seo dance德阳
# 专业企业网站建设企业
# 邵阳营销网站建设方法
# 本田
# 您的
# 人工智能
# 第三阶段
# 采用了
# 最好的
# 高质量
# 等来
# 来了
# 开源
# latte
# stable diffusion
# stable video
# sora
# openai
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
史玉柱谈AI:国内最缺是计算数学人才,曾给浙大数学系捐五千万
华为4G5G通信物联网收费标准公布,多年研发成果,十年花费近万亿
中国最强AI研究院的大模型为何迟到了
花16000元买四款扫拖机器人!科沃斯追觅石头小米谁能笑到最后?
卫星通信牵引物联网竞争升维,模组厂商如何决胜百亿市场?
清华朱军团队新作:使用4位整数训练Transformer,比FP16快2.2倍,提速35.1%,加速AGI到来!
羊驼家族大模型集体进化!32k上下文追平GPT-4,田渊栋团队出品
字节团队提出猞猁Lynx模型:多模态LLMs理解认知生成类榜单SoTA
掌阅科技对话式AI应用“阅爱聊”开启内测
长宁这家企业在世界人工智能大会上荣获“蓝鼎奖”
第二届光合组织AI解决方案大赛赛果揭晓
小米首次曝光 64 亿参数的 MiLM-6B AI 大模型,或将应用于小爱同学
Zoom远程会议应用:AI培训需经用户授权
人工智能和神经网络有什么联系与区别?
深度学习模型综述:用于3D MRI和CT扫描的应用
Vision Pro 太贵,苹果基于 iPhone 的 VR 头显专利曝光
央视报道!星纪魅族集团车载人机交互技术成世界移动通信大会焦点
数字彩排、虚拟建厂!这家顶级洗衣机工厂敲开“工业元宇宙”之门
【趋势周报】全球人工智能产业发展趋势:OpenAI向美国专利局提交“GPT-5”商标申请
业内领先 四川大学华西第四医院甲状腺乳腺外科成功进入手术机器人时代
原小米 9 号员工李明打造全球首款 AI 安卓桌面机器人
学而思推出AI第一课:基于自研大模型的AIGC课程
IBM将模拟计算用于人工智能,重塑AI计算
美图公司影像节或发布AI设计新品
一文看懂基础模型的定义和工作原理
NTU、上海AI Lab整理300+论文:基于Transformer的视觉分割最新综述出炉
尼康尼克尔 Z 180-600mm f/5.6-6.3 VR 镜头发布,12499 元
推动企业数字化转型升级!“松江智造”摘世界人工智能大会重磅奖项
探展WAIC | 第四范式“式说”聚焦toB大模型,布局生成式AI重构企业软件
中国气象局预测:到 2030 年,中国人工智能气象应用将达到国际领先水平
令人惊叹!AI模型能够以iPhone照片为基础创作诗歌
当孔子遇见AI|尼山的“数字”
70年前他本想逃避考试,却影响了整个互联网
人工智能产业协同创新中心:全产业链资源在这里汇聚
阿里达摩院发布免费开放100项AI专利许可的动机是什么?
“五年内人类程序员将消失”预言引争议,AI真的那么强大了吗?
WHEE使用教程
Meta 开源 AI 语言模型 MusicGen,可将文本和旋律转化为完整乐曲
三星加速AR眼镜进程,预计明年上半年亮相
华为云发布华为云盘古模型3.0和升腾AI云服务,亮点亮相2025华为开发者大会
日入400万,第一批AI骗子已上岗
Valve 将拒绝采用 AI 生成未知版权内容的游戏上架 Steam
AIGC 风潮刮到游戏产业,巨人网络与阿里云达成“游戏 +AI ”合作
学而思网校推出首个基于自研大模型的《人工智能第一课》
基于信息论的校准技术,CML让多模态机器学习更可靠
映宇宙数字人“映映”亮相ChinaJoy,展示AI黑科技实现用户互动
DreamAvatar数字人使用教程
中国联通发布图文AI大模型,可实现以文生图、视频剪辑
WAIC 2025|云深处科技绝影Lite3与X20四足机器人亮相
类GPT模型训练提速26.5%,清华朱军等人用INT4算法加速神经网络训练
2024-03-18

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。
