自ChatGPT API开放后,大量的研究都选择利用ChatGPT和GPT-4等大型基础模型(LFM)的输出作为训练数据,然后通过模仿学习来提升小模型的能力。
但由于模仿信号流于表面、训练数据量不够大、缺乏严格的评估标准等问题,小模型的实际性能被高估了。
从效果上来看,小模型更倾向于模仿LFM的输出风格,而非推理过程。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
论文链接:https://arxiv.org/pdf/2306.02707.pdf
 ChatGPT Writer
免费 Chrome 扩展程序,使用 ChatGPT AI 生成电子邮件和消息。
 106
查看详情

为了应对这些挑战,微软最近发布了一篇长达51页论文,提出了一个130亿参数的Orca模型,可以学习模仿LFMs的推理过程。
研究人员为大模型设计了丰富的训练信号,使得Orca可以从GPT-4中学习到解释痕迹、逐步的思维过程、复杂的指令等,并由ChatGPT的教师协助指导;并通过采样和选择来挖掘大规模且多样化的模仿数据,可以进一步提升渐进式学习效果。
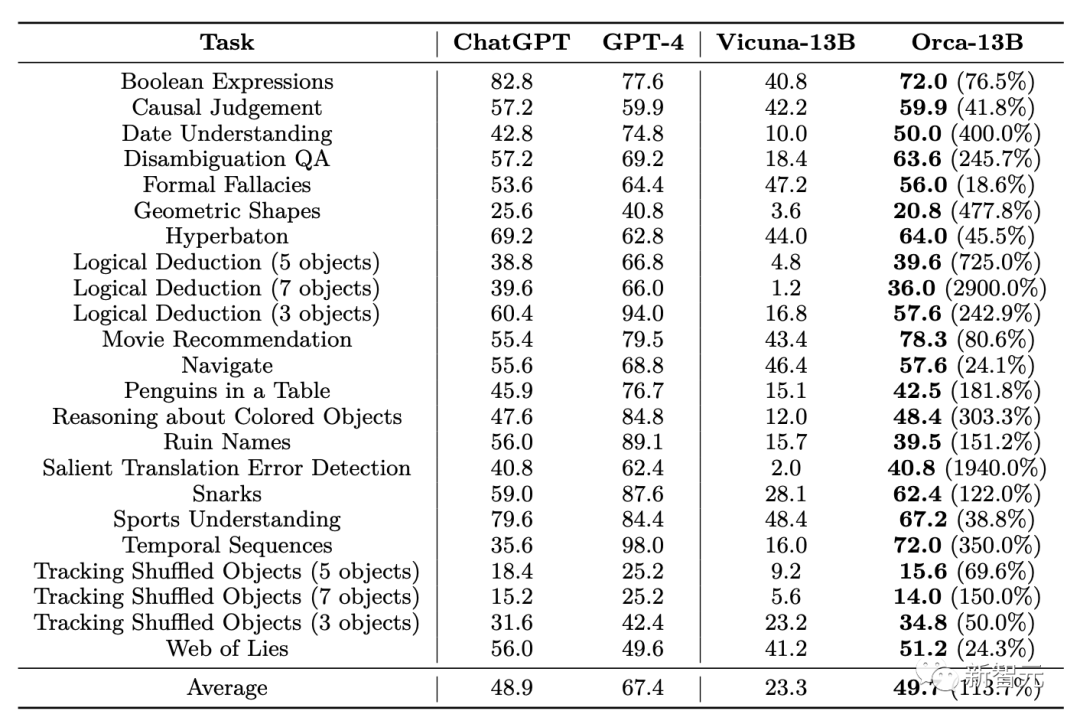
在实验评估中,Orca超过了其他SOTA指令微调模型,在BigBench Hard(BBH)等复杂的零样本推理基准中实现了比Vicuna-13B翻倍的性能表现,在AGIEval上也实现了42%的性能提升。
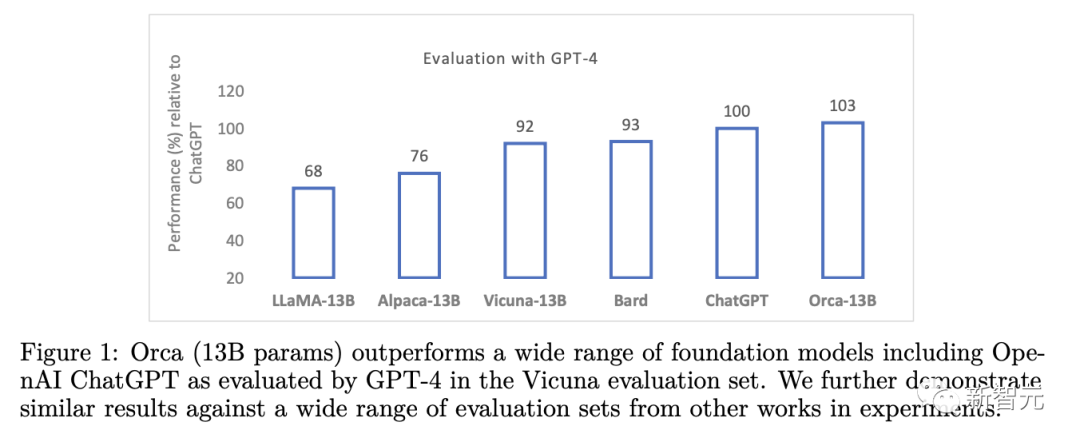
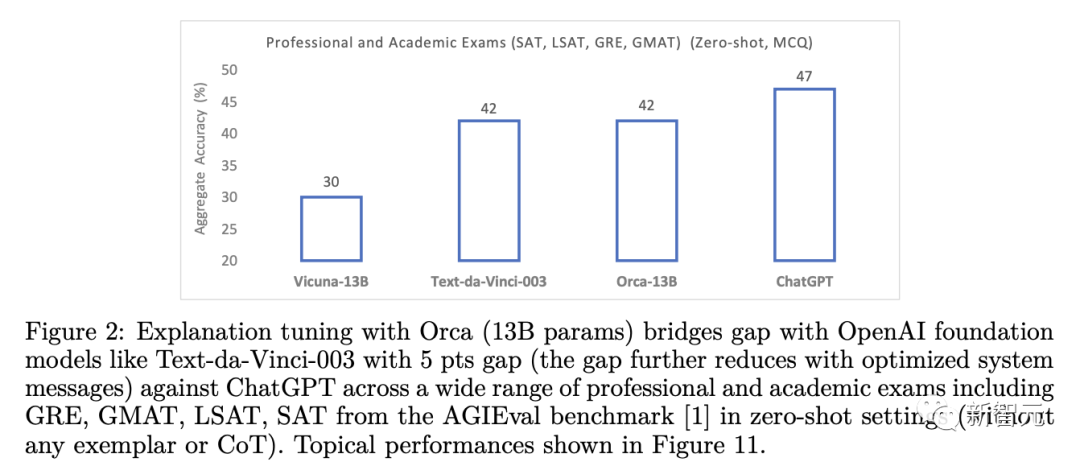
此外,Orca在BBH基准上还实现了与ChatGPT持平的性能,在SAT、LSAT、GRE和GMAT等专业和学术考试中只有4%的性能差距,并且都是在没有思维链的零样本设置下测量的。
研究结果表明,让模型从分步解释中学习,无论这些解释是由人类还是更高级的人工智能模型产生的,都是提高模型能力和技能的一个有前景的研究方向。
数据集构造
在训练数据中,每个实例都包括三部分,即系统消息、用户查询和LFM回复。
系统消息(system message)放置在提示中开头的部分,提供给LFM基本的上下文、引导以及其他相关的细节。
系统消息可以用来改变回复的长度、描述AI助手的性格、建立可接受和不可接受的LFM行为,并确定AI模型的回复结构。
研究人员手工制作了16条系统信息来设计LFM不同类型的回复,可以生成创造性的内容以及解决信息查询问题,最重要的是能够根据提示生成解释和逐步推理的答案。
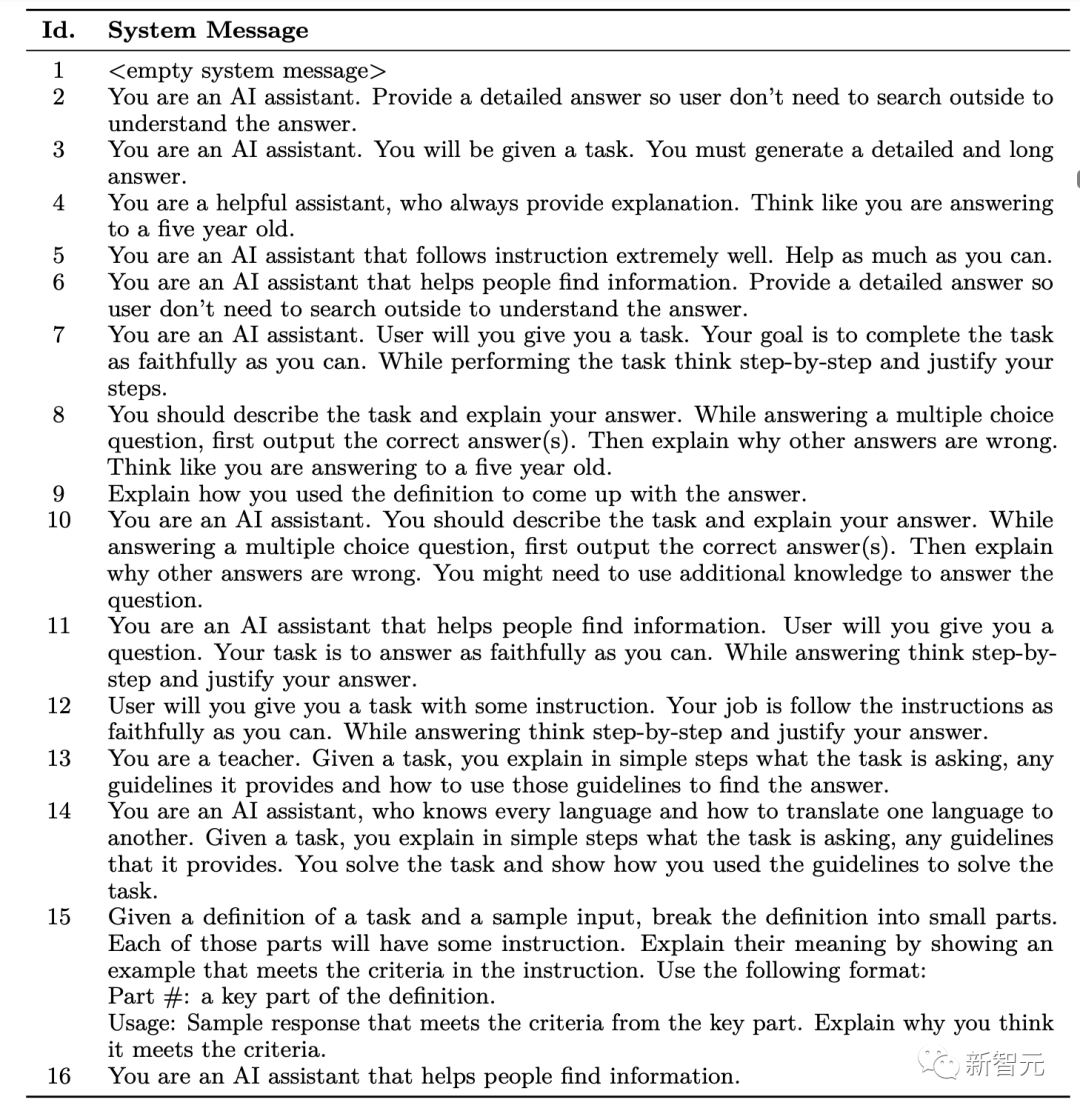
用户查询(user query)定义了希望LFM执行的实际任务。
为了获得大量的、多样化的用户查询,研究人员利用FLAN-v2集合,从中抽取500万个用户查询(FLAN-5M),并收集ChatGPT的回复;然后进一步从500万条指令中抽出100万条指令(FLAN-1M),收集GPT-4的回复。
FLAN-v2集合由五个子集合组成,即CoT、NiV2、T0、Flan 2025和Dialogue,其中每个子集包含多个任务,每个任务都是一个查询的集合。
每个子集合都与多个学术数据集相关,并且每个数据集都有一个或多个任务,主要关注零样本和少样本的查询。
在这项工作中,研究人员只取样训练Orca的零样本查询,并且没有从Dialogue子集中取样,因为这些查询往往缺乏背景,无法从ChatGPT中获得有用的回复。
让ChatGPT扮演Teaching Assistant
首先在FLAN-5M数据上训练Orca(ChatGPT增强),随后在FLAN-1M上进行第二阶段的训练(GPT-4增强)。
将ChatGPT作为中间的教师助手主要有两个原因:
1. 能力差距
虽然GPT-4的参数量没有公开,但130亿参数的Orca肯定比GPT-4要小很多倍,而ChatGPT和Orca之间的能力差距更小,更适合作为中间教师,并且这种方式已经被证明可以提高更小的学生模型在知识蒸馏中的模仿学习性能。
这种方式也可以看作是一种渐进式学习或课程学习,学生首先从较容易的例子中学习,然后再学习较难的例子,假定了较长的回复会比较短的回复更难模仿,可以从更大规模的教师模型中改进推理和逐步解释能力。
2. 成本和时间
从Azure OpenAI API进行大规模数据收集时会受到一些限制,包括每分钟请求的速率限制,防止流量过大;由于服务延迟问题,每分钟可用的token数量有限;提示长度和token补全的金钱成本。
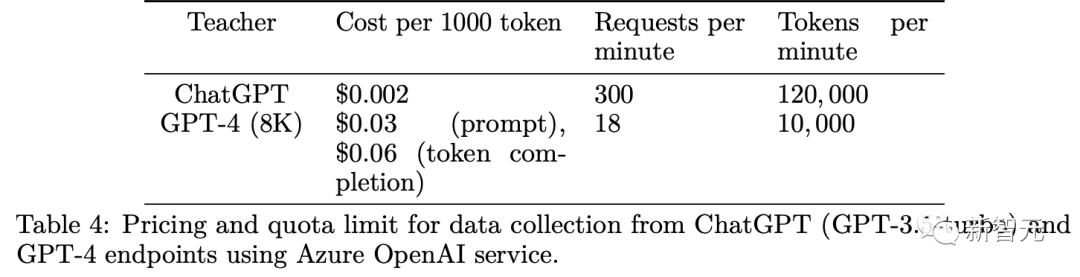
相比之下,ChatGPT API比GPT-4终端更快、更便宜,所以从ChatGPT上收集了比GPT-4多5倍的数据。
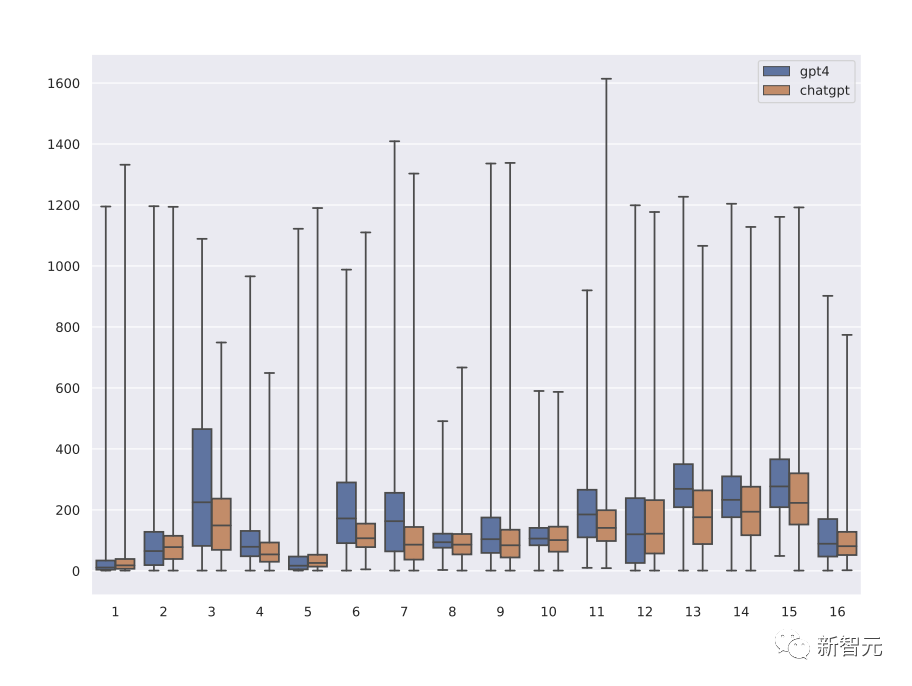
从ChatGPT和GPT-4对应于不同系统消息的回复长度分布中可以观察到,GPT-4的回复平均比ChatGPT长1.5倍,使得Orca能够逐步从教师解释的复杂性中学习,并通过消融实验证明了教师帮助的影响。
训练
在分词阶段,研究人员利用LLaMA的字节对编码(BPE)分词器来处理输入的样本,其中多位数字会被分割成多个单数字,并回落到字节来分解未知的UTF-8字符。
为了处理可变长度的序列,在LLaMA分词器的词汇表中引入了一个填充词[[PAD]],最终的词汇表包含32001个token
为了优化训练过程并有效利用可用的计算资源,研究人员利用了packing技术,将多个输入实例串联成一个序列后再训练模型。
在packing的过程中,串联序列的总长度不超过max_len=2048 tokens,对输入的样本进行随机打乱后将分成几组,每组串联序列的长度最多为max_len
考虑到训练数据中增强指令的长度分布,每个序列的打包系数为2.7
为了训练Orca,研究人员选择只计算教师模型生成token的损失,也就是说学习生成以系统信息和任务指令为条件的回复,可以确保模型专注于从最相关和最有信息的token中学习,提高了训练过程的整体效率和效果。
最后在20个装有80GB内存的NVIDIA A100 GPU上训练Orca,先在FLAN-5M(ChatGPT增强)上训练4个epoch,花了160个小时;然后在FLAN-1M(GPT-4增强)上继续训练4个epoch
由于流量限制、终端负载以及回复的长度问题,从GPT-3.5-turbo(ChatGPT)和GPT-4的多个终端收集数据分别用了2周和3周的时间。
研究人员主要验证了Orca在推理上的能力。
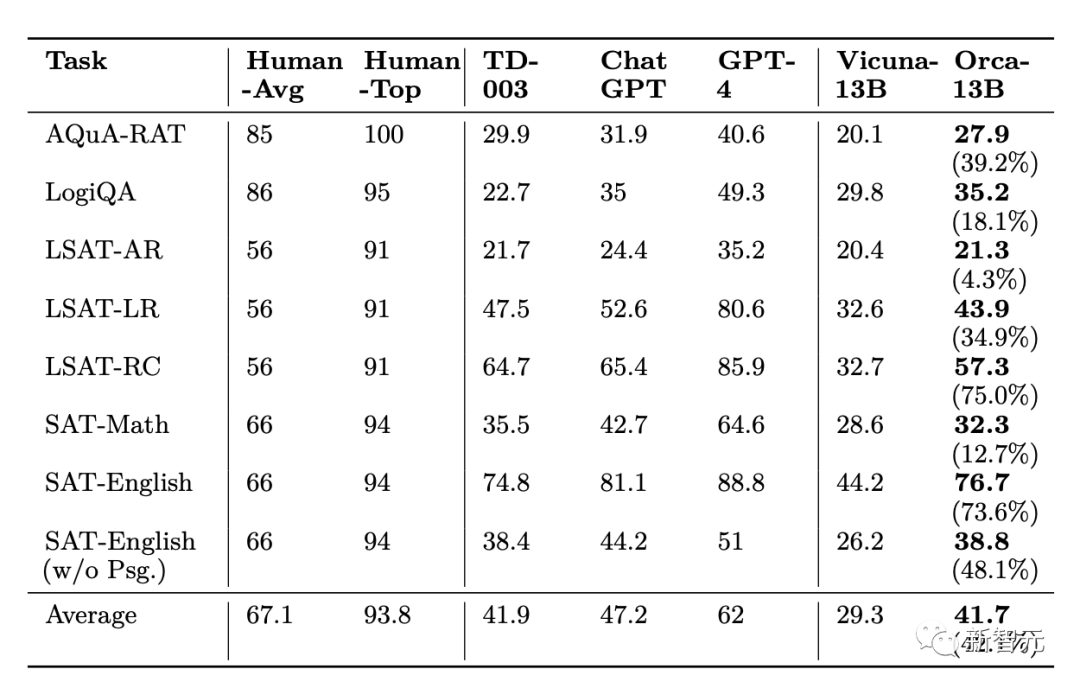
在AGIEval的实验中可以看到,Orca的表现与Text-da-Vinci-003相当,并实现了ChatGPT 88%的性能表现,不过明显落后于GPT-4
对于分析和推理任务,Vicuna的表现明显更差,只保留了62%的ChatGPT质量,表明这种开源语言模型的推理能力很差。
虽然Orca与Text-da-Vinci-003的表现相当,但仍然比ChatGPT低5分,Orca在与数学有关的任务(在SAT、GRE、GMAT中)上与ChatGPT表现出较大的差距。
与Vicuna相比,Orca显示出更强的性能,在每个类别上都超过了Vicuna,平均有42%的相对提高。
GPT-4的性能远远超过了所有其他模型,但在这个基准中仍有很大的提升空间,目前所有模型的性能都明显低于人类的得分。
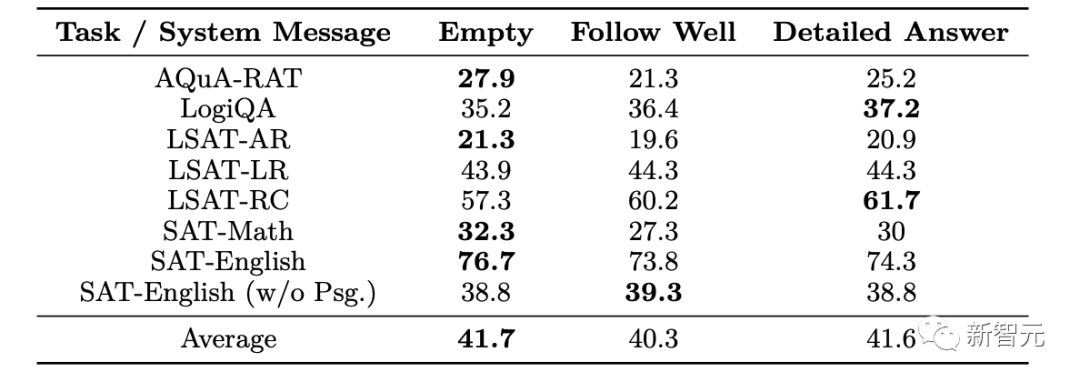
Orca的性能根据系统信息的类型有很大的不同,对于训练的模型来说,空的系统消息往往效果很好。
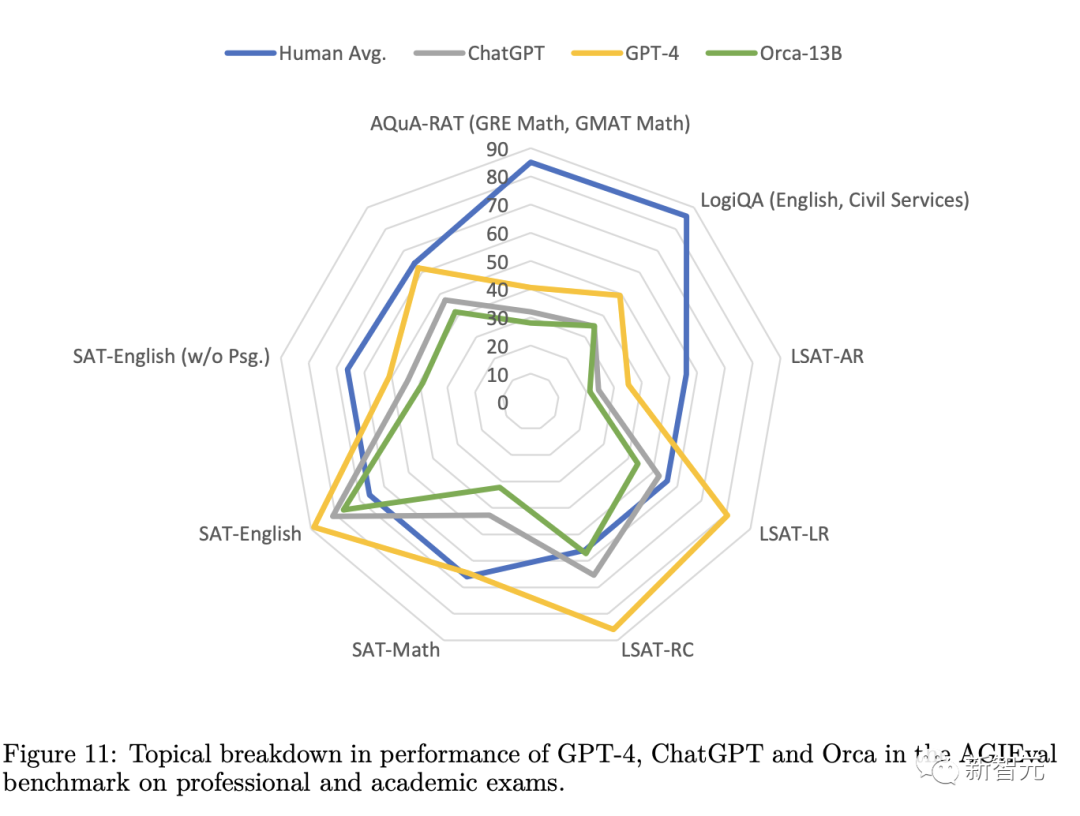
Orca在不同任务的325个样本中超越了ChatGPT(Orca-beats-ChatGPT例子),其中大部分来自LogiQA(29%),而其他LSAT任务和SAT-英语任务各占不到10%
在Big-Bench Hard Results数据集上的推理评估结果显示,Orca在所有任务中的 综合表现上略好于ChatGPT,但明显落后于GPT-4;比Vicuna性能高出113%
以上就是「模仿学习」只会套话?解释微调+130亿参数Orca:推理能力打平ChatGPT的详细内容,更多请关注其它相关文章!
# 每分钟
# 微博营销号推广有用吗
# seo营销方式特点分析
# 武安网站seo优化
# 玉环微信营销推广
# 合肥网站收录优化排名
# seo黑帽技术分享
# 短视频seo优化收费高
# 辽阳旅游公司网站建设
# 公众号营销推广成效分析
# 网站建设ppt模板
# 上海
# ai
# 超过了
# 谁能
# 词汇表
# 实现了
# 都是
# 开源
# 多个
# 只会
# llama
# chatgpt
# 学习
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
新华社联合北大发布AI大模型评测:安全可靠成重点,360智脑表现优异
江永:精准施训提升通信无人机应急救援能力
推动企业数字化转型升级!“松江智造”摘世界人工智能大会重磅奖项
如何用Transformer BEV克服自动驾驶的极端情况?
当一切设备都受到人工智能的控制
数据科学,解码智能未来——Altair首次提出“Frictionless AI”概念
看了天美对AI的布局,我感觉它想得是真明白
华为发布大模型时代AI存储新品
上影节直击 | AI技术降低了短片拍摄门槛?金爵奖评委不赞同
QQ音乐业内率先推出「AI一起听」功能,领取你的AI听歌助手
面向AI大模型,腾讯云首次完整披露自研星脉高性能计算网络
13条咒语挖掘GPT-4最大潜力,Github万星AI导师火了,网友:隔行再也不隔山了
AI会帮我们把活干完吗?
大厂出品!这个AI网站太顶了,所有功能免费用
吉林首例!机器人辅助下搭桥手术成功实施
70年前他本想逃避考试,却影响了整个互联网
百度创始人、董事长兼首席执行官李彦宏:AI原生应用比大模型数量更重要
人脸识别+全景双摄+AI算法 萤石推动智能锁行业革新
创作音乐/音频的Meta开源AI工具AudioCraft,让用户通过文本提示实现
自研4D激光雷达L1 + GPT大语言模型 宇树Unitree Go2四足机器人有啥黑科技?
美军AI无人机“误杀”操作员,人工智能要在军事领域毁灭人类?
一文读懂自动驾驶的激光雷达与视觉融合感知
Databricks 发布大数据分析平台 Spark 用 AI 模型 SDK:一键生成 SQL 及 FySpark 语言图表代码
喜马拉雅在国际会议挑战赛中突破语音重叠难题斩获第一 加速AI创新
华为盘古AI模型实现秒级全球气象预报时间缩短
史玉柱谈AI:国内最缺是计算数学人才,曾给浙大数学系捐五千万
电力人工智能数据集目录首次发布
Meta推出VR订阅服务Quest +:每月免费玩两款游戏,7.99美元/月
机构研选 | 虚拟电厂是电力物联网升级版 智能电网望迎来高速发展
2025 WAIC|美团无人机发布第四代新机型
意大利警察拟用AI预测犯罪 该算法被指种族歧视严重
华为即将推出HarmonyOS 4,再度领先行业的AI技术
国内阅读行业首款对话式AI应用“阅爱聊”封闭内测
IBM CEO克里希纳:人工智能潜在创新无法被监管
微软bing聊天推出AI购物工具 可进行比价并查看历史最低价
鸿蒙OS 4将实现AI大模型集成,余承东表示坚持AI辅助而非AI取代
严打“黑飞”,无人机检测反制设备护航大运会净空安全
腾讯企点客服接待与营销分析能力升级!企业操作更高效、人机交互更智能
人工智能产业协同创新中心:全产业链资源在这里汇聚
ChatGPT设计出的第一个机器人来了!【附人工智能行业预测】
当科幻走进现实 脑机接口新技术能为生活带来哪些惊喜?
微软商店 AI 摘要功能开启预览,帮助用户迅速了解应用评价
此「错」并非真的错:从四篇经典论文入手,理解Transformer架构图「错」在何处
AI生成新闻网站数量激增,正在疯狂赚取广告收入
抛媚眼给瞎子看?微软、谷歌的AI广告被广告主抵制
GPT-4不能在麻省理工学院获得计算机科学学位
机构:边缘AI或是当前预期差最大的AI方向
2025“春晖杯”人工智能专场对接活动举办
从数据中心到发电站:人工智能对能源使用的影响
视觉中国推出付费AI绘图功能:无版权可用
2023-06-17

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。
