在 AI 绘画领域,阿里提出的 Composer 和斯坦福提出的基于 Stable diffusion 的 ControlNet 引领了可控图像生成的理论发展。但是,业界在可控视频生成上的探索依旧处于相对空白的状态。
相比于图像生成,可控的视频更加复杂,因为除了视频内容的空间的可控性之外,还需要满足时间维度的可控性。基于此,阿里巴巴和蚂蚁集团的研究团队率先做出尝试并提出了 VideoComposer,即通过组合式生成范式同时实现视频在时间和空间两个维度上的可控性。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
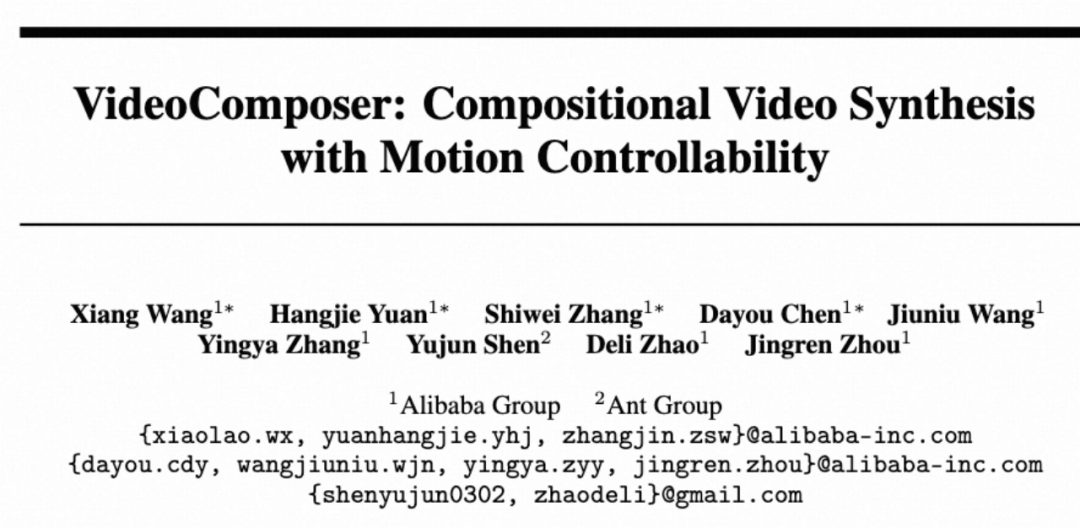
前段时间,阿里巴巴在魔搭社区和 Hugging Face 低调开源了文生视频大模型,意外地受到国内外开发者的广泛关注,该模型生成的视频甚至得到马斯克本尊的回应,模型在魔搭社区上连续多天获得单日上万次国际访问量。
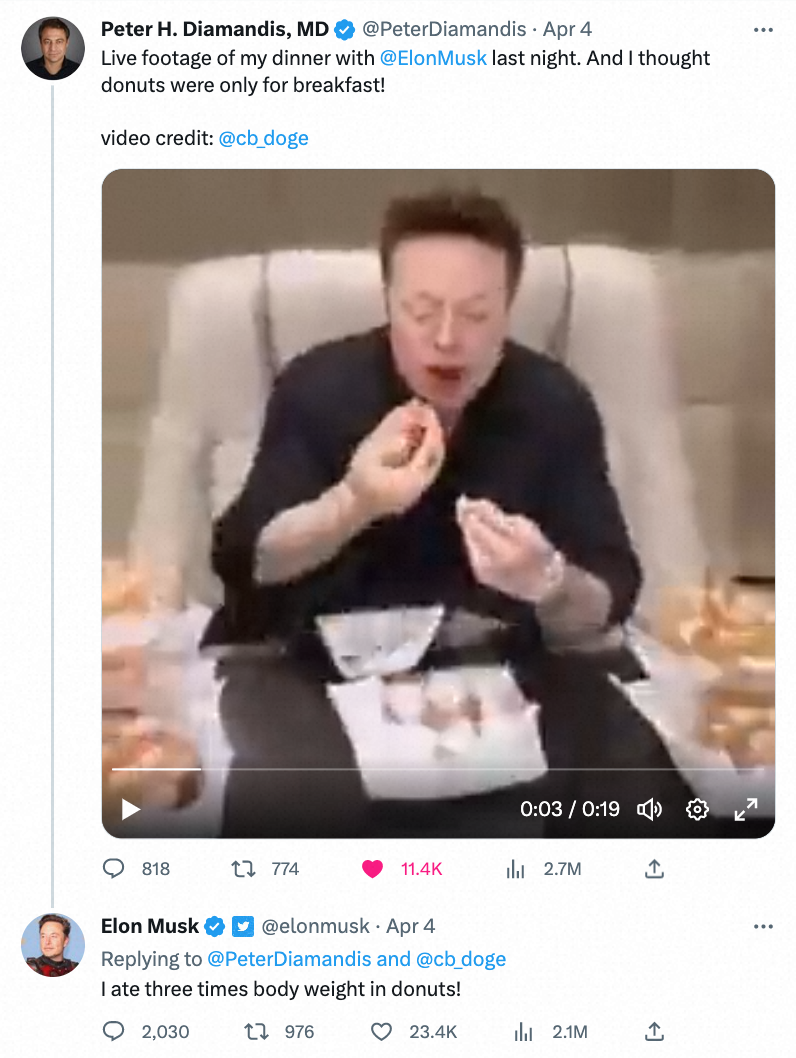
Text-to-Video 在推特
VideoComposer 作为该研究团队的最新成果,又一次受到了国际社区的广泛关注。
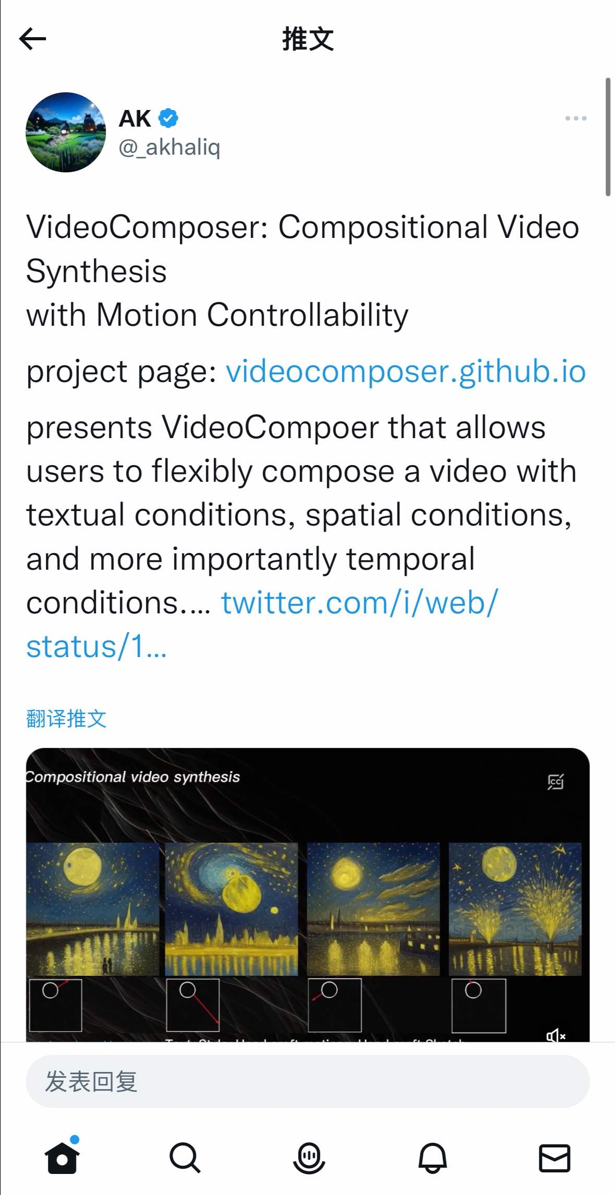
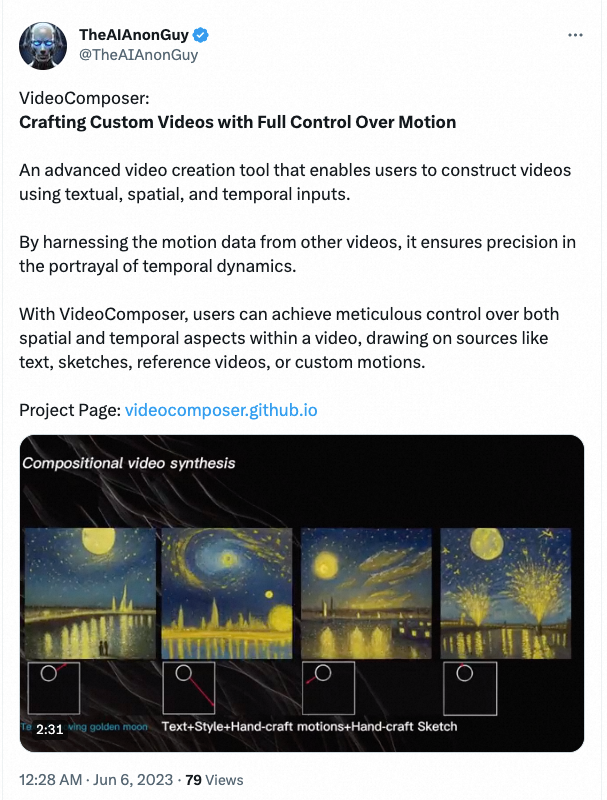
VideoComposer 在推特
事实上,可控性已经成为视觉内容创作的更高基准,其在定制化的图像生成方面取得了显着进步,但在视频生成领域仍然具有三大挑战:
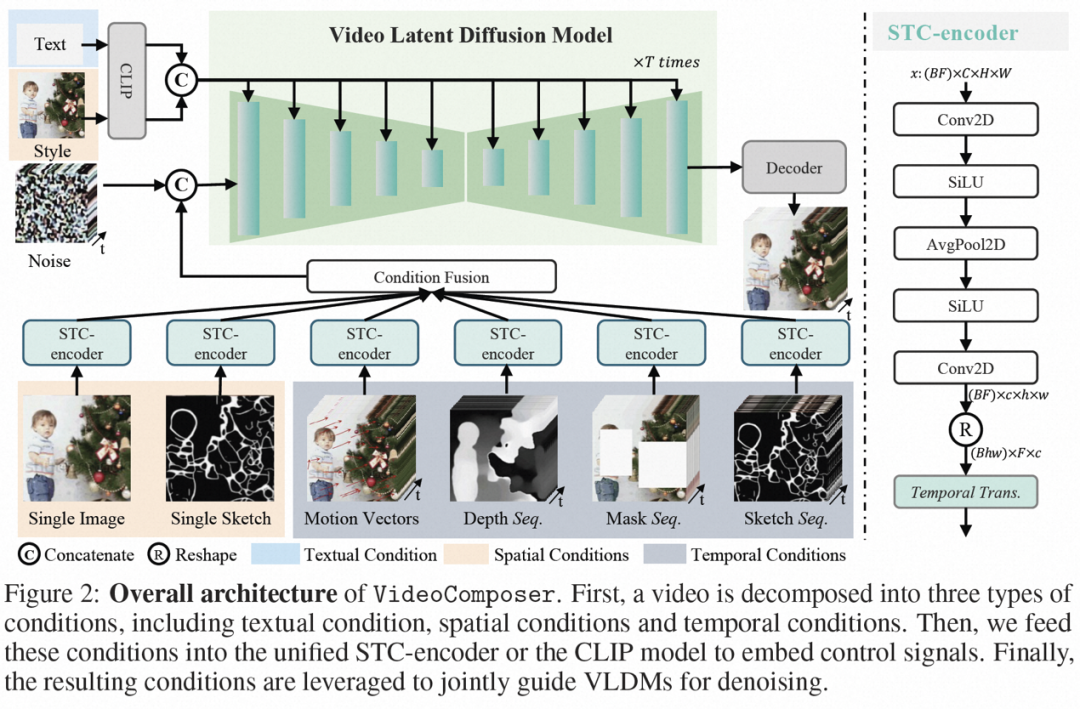
在此之前,阿里巴巴提出的 Composer 已经证明了组合性对图像生成可控性的提升具有极大的帮助,而 VideoComposer 这项研究同样是基于组合式生成范式,在解决以上三大挑战的同时提高视频生成的灵活性。具体是将视频分解成三种引导条件,即文本条件、空间条件、和视频特有的时序条件,然后基于此训练 Video LDM (Video Latent Diffusion Model)。特别地,其将高效的 Motion Vector 作为重要的显式的时序条件以学习视频的运动模式,并设计了一个简单有效的时空条件编码器 STC-encoder,保证条件驱动视频的时空连续性。在推理阶段,则可以随机组合不同的条件来控制视频内容。
实验结果表明,VideoComposer 能够灵活控制视频的时间和空间的模式,比如通过单张图、手绘图等生成特定的视频,甚至可以通过简单的手绘方向轻松控制目标的运动风格。该研究在 9 个不同的经典任务上直接测试 VideoComposer 的性能,均获得满意的结果,证明了 VideoComposer 通用性。
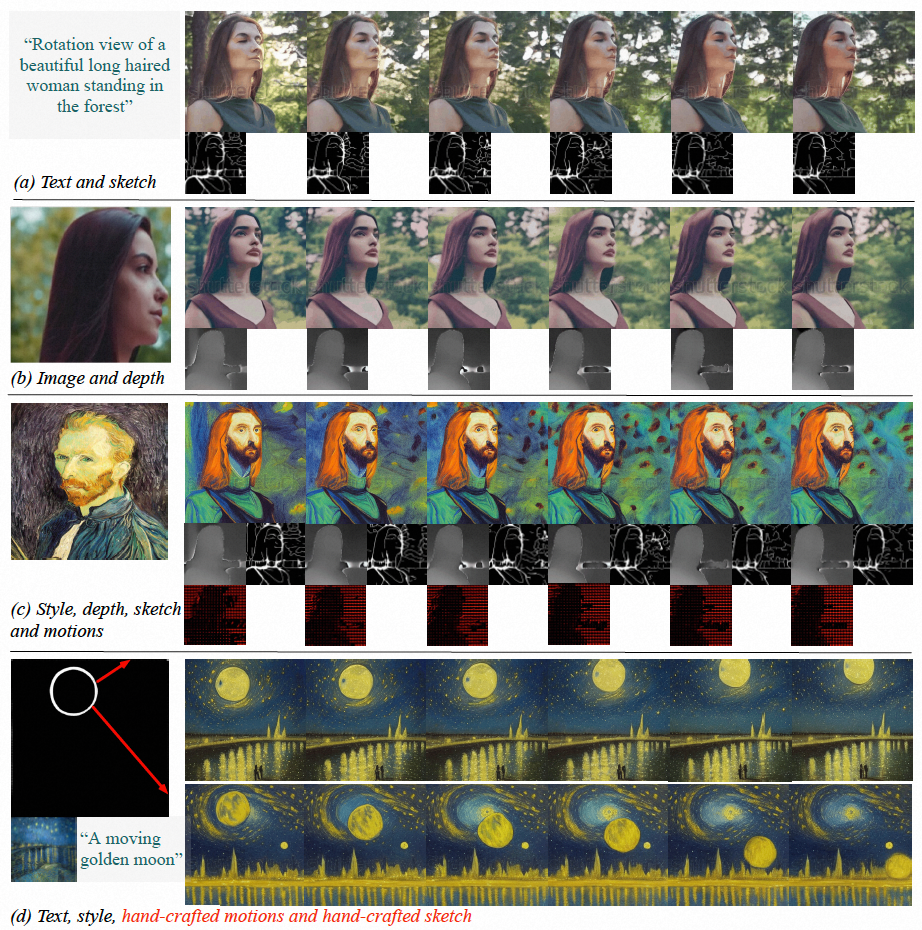
图 (a-c)VideoComposer 能够生成符合文本、空间和时间条件或其子集的视频;(d)VideoComposer 可以仅仅利用两笔画来生成满足梵高风格的视频,同时满足预期运动模式(红色笔画)和形状模式(白色笔画)
Video LDM
隐空间。Video LDM 首先引入预训练的编码器将输入的视频 。然后,在用预先训练的解码器 d 将隐空间映射到像素空间上去 扩散模型。为了学习实际的视频内容分布
免费 Chrome 扩展程序,使用 ChatGPT AI 生成电子邮件和消息。 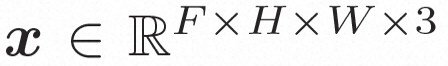
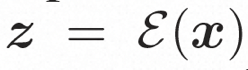 映射到隐空间表达,其中
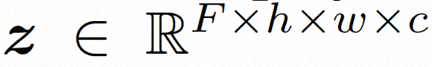
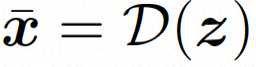 。在 videocomposer 中,参数设置
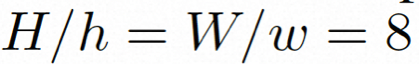
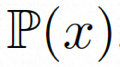
 ChatGPT Writer
 106
查看详情
 ,扩散模型学习从正态分布噪声中逐步去噪来恢复真实的视觉内容,该过程实际上是在模拟可逆的长度为 T=1000 的马尔可夫链。为了在隐空间中进行可逆过程,Video LDM 将噪声注入到


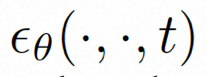

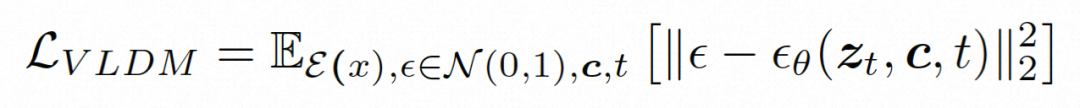
为了充分探索利用空间局部的归纳偏置和序列的时间归纳偏置进行去噪,VideoComposer 将 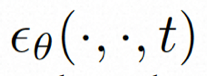
VideoComposer
组合条件。 VideoComposer 将视频分解为三种不同类型的条件,即文本条件、空间条件和关键的时序条件,它们可以共同确定视频中的空间和时间模式。VideoComposer 是一个通用的组合式视频生成框架,因此,可以根据下游应用程序将更多的定制条件纳入 VideoComposer,不限于下述列出的条件:
时空条件编码器。序列条件包含丰富而复杂的时空依赖关系,对可控的指示带来了较大挑战。为了增强输入条件的时序感知,该研究设计了一个时空条件编码器(STC-encoder)来纳入空时关系。具体而言,首先应用一个轻量级的空间结构,包括两个 2D 卷积和一个 *gPooling,用于提取局部空间信息,然后将得到的条件序列被输入到一个时序 Transformer 层进行时间建模。这样,STC-encoder 可以促进时间提示的显式嵌入,为多样化的输入提供统一的条件植入入口,从而增强帧间一致性。另外,该研究在时间维度上重复单个图像和单个草图的空间条件,以确保它们与时间条件的一致性,从而方便条件植入过程。
通过 STC-encoder 处理条件后,最终的条件序列具有与相同的空间形状,然后通过元素加法融合。最后,沿通道维度将合并后的条件序列与连接起来作为控制信号。对于文本和风格条件,利用交叉注意力机制注入文本和风格指导。
训练和推理
两阶段训练策略。虽然 VideoComposer 可以通过图像 LDM 的预训练进行初始化,其能够在一定程度上缓解训练难度,但模型难以同时具有时序动态感知的能力和多条件生成的能力,这个会增加训练组合视频生成的难度。因此,该研究采用了两阶段优化策略,第一阶段通过 T2V 训练的方法,让模型初步具有时序建模能力;第二阶段在通过组合式训练来优化 VideoComposer,以达到比较好的性能。
推理。在推理过程中,采用 DDIM 来提高推理效率。并采用无分类器指导来确保生成结果符合指定条件。生成过程可以形式化如下:
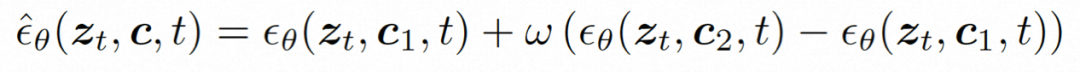
其中,ω 是指导比例;c1 和 c2 是两组条件。这种指导机制在两条件集合判断,可以通过强度控制来让模型具有更加灵活的控制。
在实验探索中,该研究证明作为 VideoComposer 作为统一模型具有通用生成框架,并在 9 项经典任务上验证 VideoComposer 的能力。
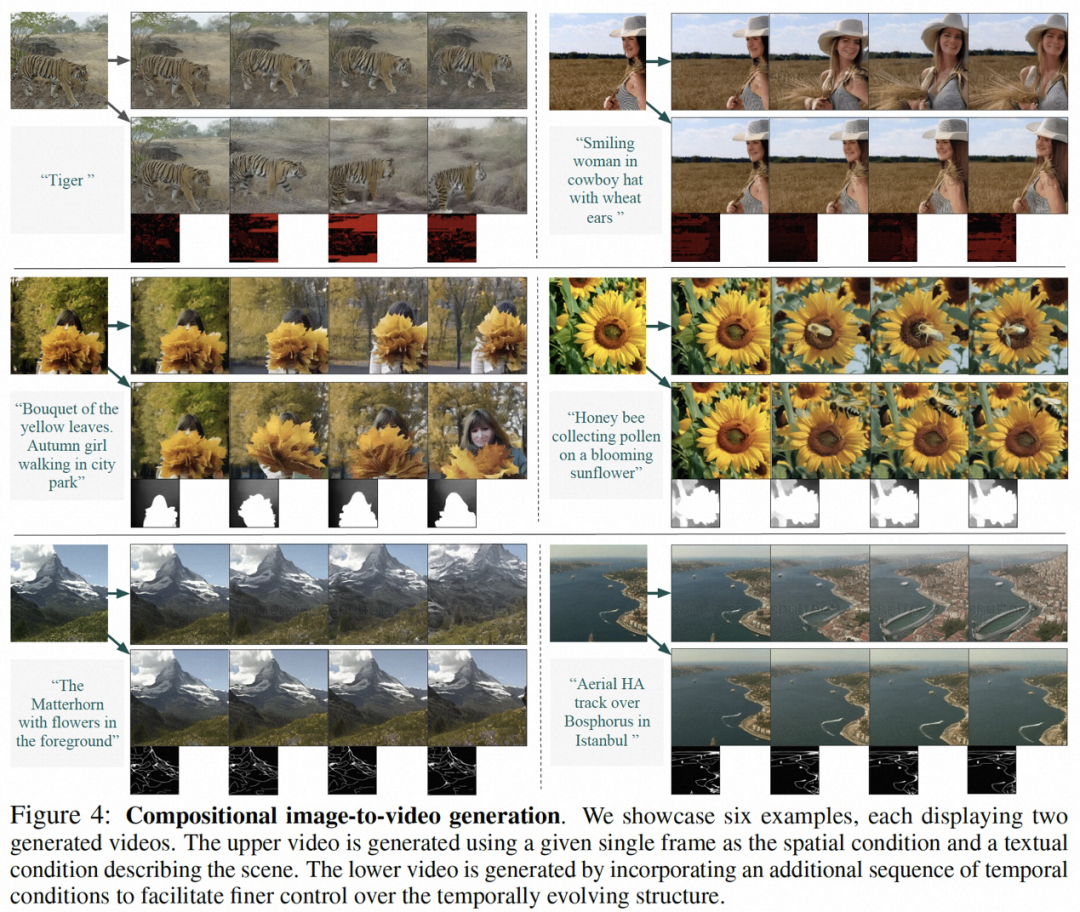
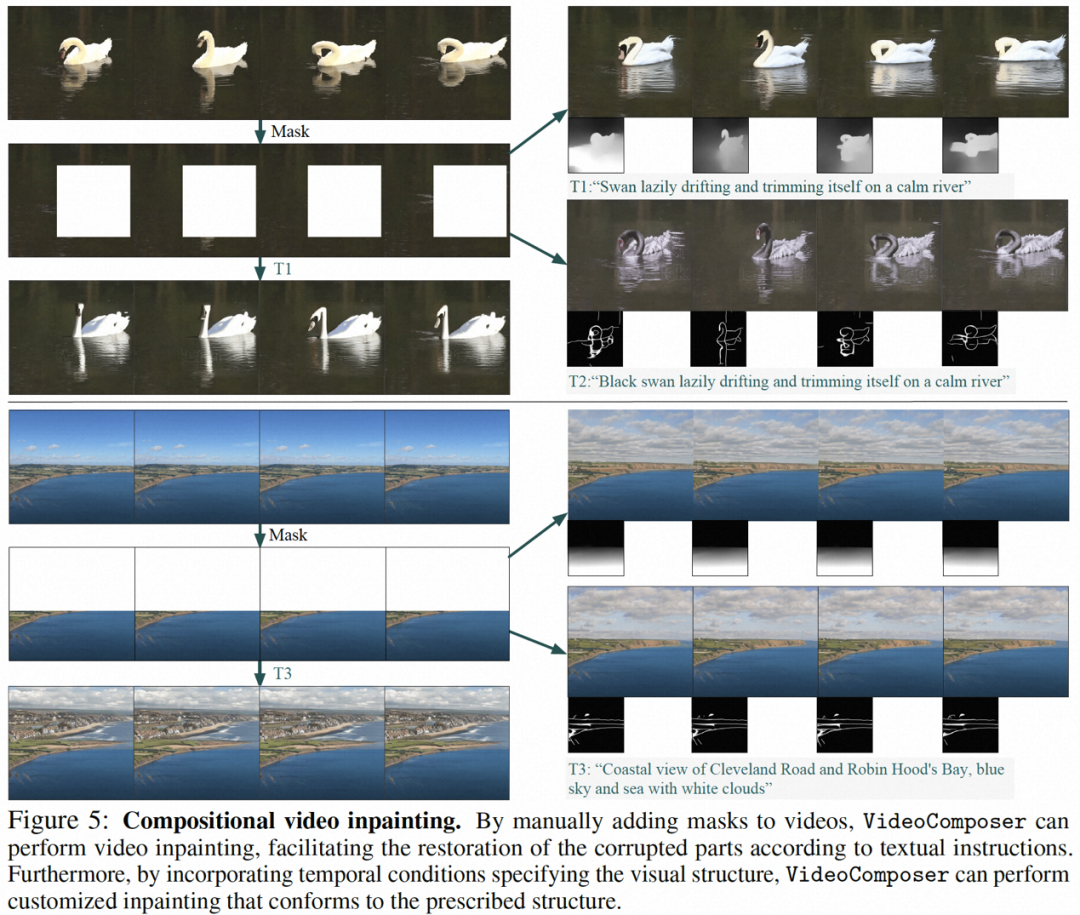
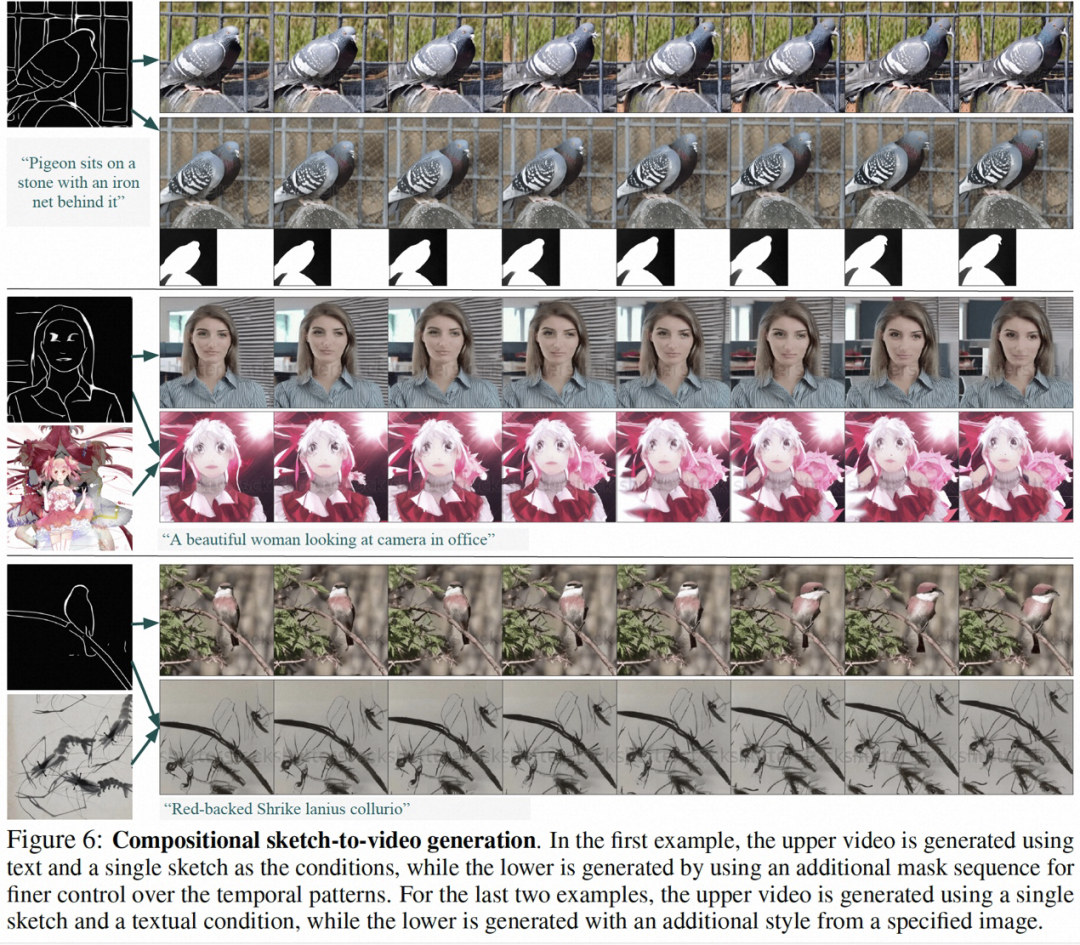
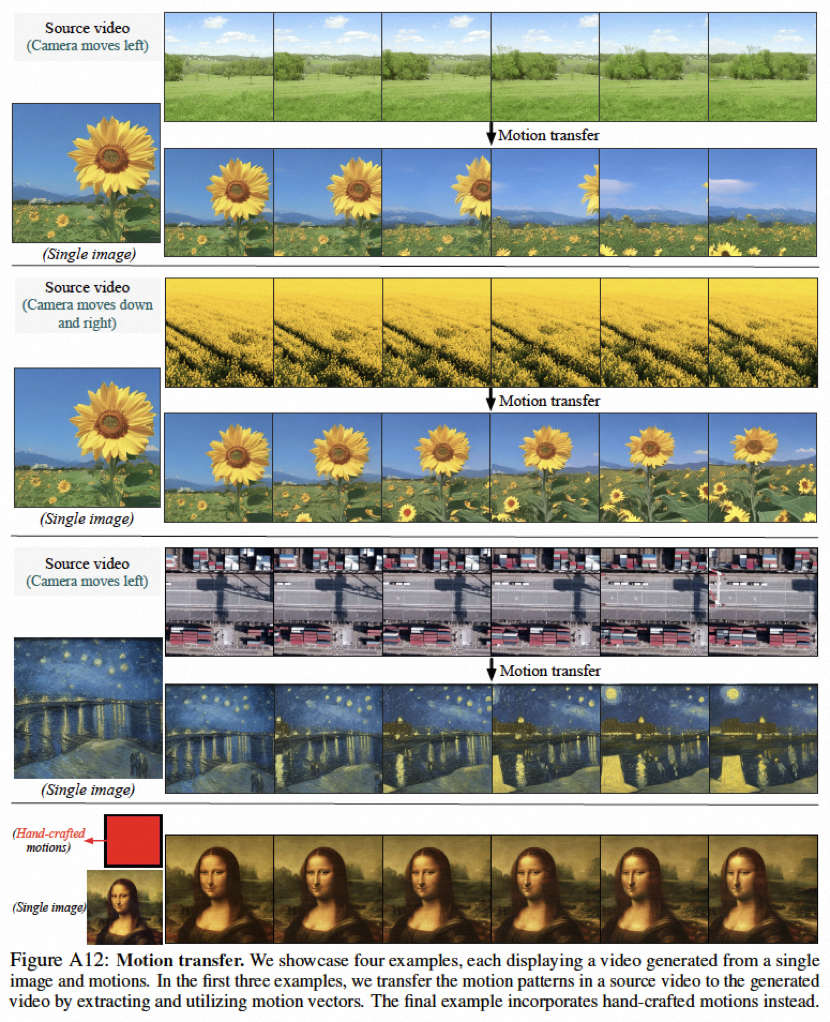
该研究的部分结果如下,在静态图片到视频生成(图 4)、视频 Inpainting(图 5)、静态草图生成生视频(图 6)、手绘运动控制视频(图 8)、运动迁移(图 A12)均能体现可控视频生成的优势。
公开信息显示,阿里巴巴在视觉基础模型上的研究主要围绕视觉表征大模型、视觉生成式大模型及其下游应用的研究,并在相关领域已经发表 CCF-A 类论文 60 余篇以及在多项行业竞赛中获得 10 余项国际冠军,比如可控图像生成方法 Composer、图文预训练方法 RA-CLIP 和 RLEG、未裁剪长视频自监督学习 HiCo/HiCo++、说话人脸生成方法 LipFormer 等均出自该团队。
以上就是时间、空间可控的视频生成走进现实,阿里大模型新作VideoComposer火了的详细内容,更多请关注其它相关文章!
# 并在
# 玉林抖音推广营销招聘网
# 如何推广一个市场营销
# 云南seo公司报价
# 安徽矩阵营销推广哪家服务好
# 宁夏网站优化代运营
# 赣州网站建设.com
# 网站建设费用5万
# 那曲网站推广费用
# 网站优化推广费用怎么算
# 陕西短视频seo布局图
# 重庆
# 三种
# 视频
# 三大
# 转录
# 开源
# 可以通过
# 杜比
# 火了
# controlnet
# stable diffusion
# runway
# hugging face
# 阿里巴巴
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
这效果能打几分?AI真人化《名侦探柯南》
兆讯传媒率先全面拥抱AI 数智广告内容焕发新生机
“图壤·阅读元宇宙”亮相北京国际图书博览会
一次购买全年省心,入手科沃斯这几台机器人,省下时间就是金钱
全媒封面丨⑤商汤科技:原创AI算法“发电厂”
PHP和OpenCV库:如何实现人脸识别
类GPT模型训练提速26.5%,清华朱军等人用INT4算法加速神经网络训练
微幼科技晨检机器人与人工晨检相比,有何优势
首部国内AI辅助动画片《魔游纪:人工智能辅助篇》预告发布
微软在 Build 大会上宣布的新 Microsoft Store AI Hub 现已开始推出
首届亚太网络法实务大会召开 九位大咖探讨元宇宙与人工智能发展
鸿蒙生态带来了哪些新的流量可能性,包括AI、服务分发和原生智能等方面?
iPhone两秒出图,目前已知的最快移动端Stable Diffusion模型来了
鸿蒙OS 4将实现AI大模型集成,余承东表示坚持AI辅助而非AI取代
MiracleVision视觉大模型功能介绍
Adobe旗下Illustrator引入生成式AI工具Firefly
马斯克WAIC2025演讲全文:AI将对人类文明产生深远影响
华为联合合作伙伴 共同发布昇腾AI大模型训推一体化解决方案
硅谷人工智能研究院创始人皮埃罗·斯加鲁菲:Transformer模型演讲
前特斯拉总监、OpenAI大牛Karpathy:我被自动驾驶分了心,AI智能体才是未来!
Nature封面:量子计算机离实际应用还有两年
阿里达摩院发布免费开放100项AI专利许可的动机是什么?
全球首款AI裸眼3D平板 国产的售价破万
视觉中国推出AI灵感绘图功能
OPPO三方联合发布AI可持续发展白皮书,坚持发展健康AI生态
解决导航“最后50米”难题 高德地图升级AR步行导航找终点功能
OpenAI首席执行官引用《道德经》 呼吁就AI安全问题合作
拓普龙7188ML:轻便壁挂式工控机箱,为人工智能应用场景提供有力保障
华为云天筹AI求解器荣获世界人工智能大会最高奖
“思享荟”沙龙热议AIGC与元宇宙 复旦大学赵星畅谈深度数字化
机构:边缘AI或是当前预期差最大的AI方向
“木头姐”:特斯拉的人工智能训练——“赢家通吃”的机会
V社回应拒绝上架含 AI 生成内容的游戏:审核政策正在调整中
抛媚眼给瞎子看?微软、谷歌的AI广告被广告主抵制
人工智能驱动艺术,打开达利的超现实想象
RoboNeo操作教程
研究发现AI聊天机器人ChatGPT不会讲笑话,只会重复25个老梗
支持跨语言、人声狗吠互换,仅利用最近邻的简单语音转换模型有多神奇
如何成功实施人工智能?
AI成政客博弈工具,美国大选真假难辨,律师们的生意来了
MiracleVision视觉大模型
谷歌借AI打破十年排序算法封印,每天被执行数万亿次,网友却说是最不切实际的研究?
小艺将具备大模型能力,鸿蒙4加速AI普及之路
人工智能时代 数字文明对话向“尼”走来
原小米 9 号员工李明打造全球首款 AI 安卓桌面机器人
7条线路感受智慧美好生活,“2025 世界人工智能大会民营企业社会开放日”主题活动启动
百亿量化私募:量化投资进入“精耕细作”时代 AI带来行业新变革
国宝级文物“铜兽驮跪坐人顶尊铜像”完成模拟拼接,腾讯AI立功
周鸿祎参加中美青年科技创新峰会,分享人工智能创新机遇
携程发布旅游行业垂直大模型 梁建章:AI策略是做可靠的内容 放心的推荐
2023-06-15

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。
