本文介绍单阶段检测模型YOLOF,其仅用一层特征层便达到多层特征层检测效果,速度领先。作者将检测分encoder和decoder,提出单进单出的Dilated Encoder及Uniform Matching组件,解决相关问题。对比其他模型,YOLOF精度相当或更高,速度更快、耗时更少。还介绍了其复现过程、结果、代码及使用方法。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
论文地址:https://arxiv.org/abs/2103.09460
YOLOF是一个单阶段检测模型,它成功地只使用了一层特征层,就达到了使用多层特征层(FPN)进行检测一样的效果,并在速度上遥遥领先于多特征层检测器。
与其他模型对比:
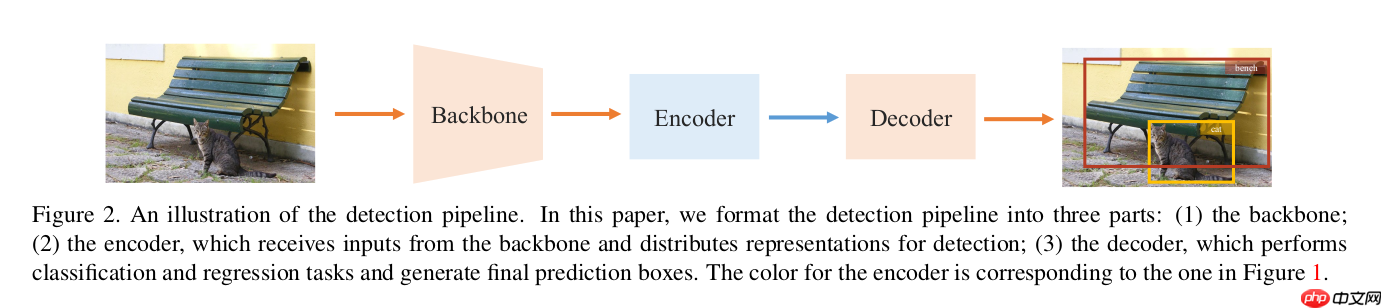
首先作者将检测的过程分为encoder和decoder:
如下图所示:
然后作者尝试了多种encoder结构,包括多进多出,单进多出,多进单出,单进单出,发现单进多出能达到多进多出(FPN)差不多的精度,如下图:
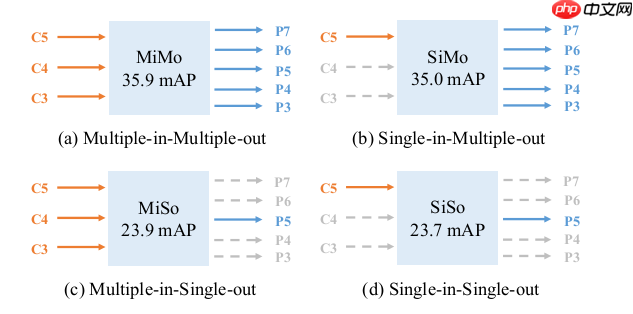
所以得出结论:FPN的效果得益于分而治之而并非多层特征融合。基于这样的观察,作者提出YOLOF,成功地在单特征层上进行高效地目标检测。
YOLOF有两个重要的组件,Dilated Encoder和Uniform Matching:
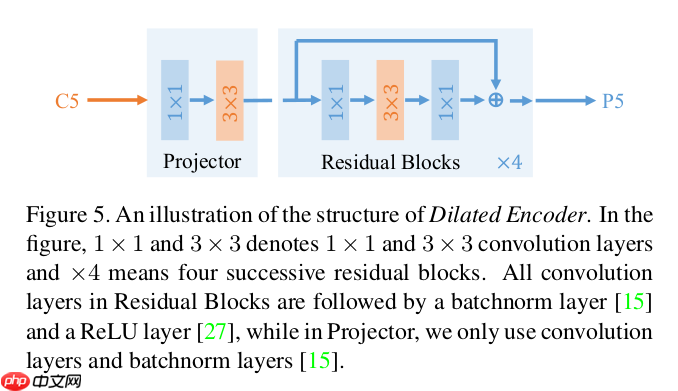
Dilated Encoder其实是一个单进单出的neck,它的结构如上图所示,它由Projector和Residual Blocks两部分组成。首先C5特征层经过1x1的卷积将通道从2048降到512,然后通过一个3x3的卷积对语义信息进行refine,这是Projector部分。然后是一组residual blocks,每个block中的卷积层均采用了空洞卷积,并加入了残差模块,这是Residual Blocks部分。作者使用了4个residual blocks,空洞大小分别为2,4,6,8。最后输出的检测特征层具有和C5一样的stride(32)。
据作者描述,空洞卷积的作用是高效地增大感受野,残差模块是将不同感受野的特征融合到一个特征层上。
由于只用了一层特征层,anchor的分布变得非常稀疏,导致大物体更容易被匹配到,为了解决这种不平衡,作者提出了Uniform Matching,每个GT选取k个最接近的anchor进行匹配,从而保证了每个GT都有足够多的样本进行学习。
最后YOLOF具有如下结构:
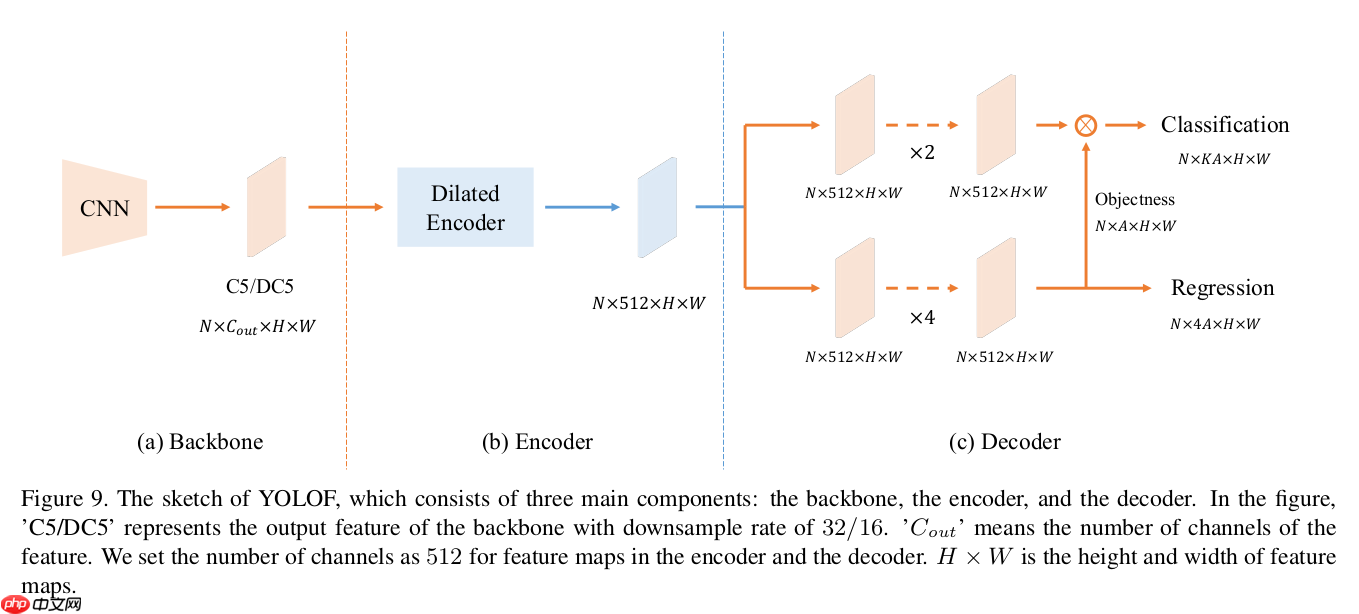
在最后的检测模块,YOLOF使用用2个卷积层作为分类分支,4个卷积层作为回归分支,在回归分支上还加入了隐性objectness,最后并入分类结果合并作为最后的分类分数。隐性的意思是没有监督信息去监督objectness的学习。
下图是和RetinaNet对比的结果,RetinaNet+是补上了GN,implicit objectness,GIoU这些trick后的RetinaNet。
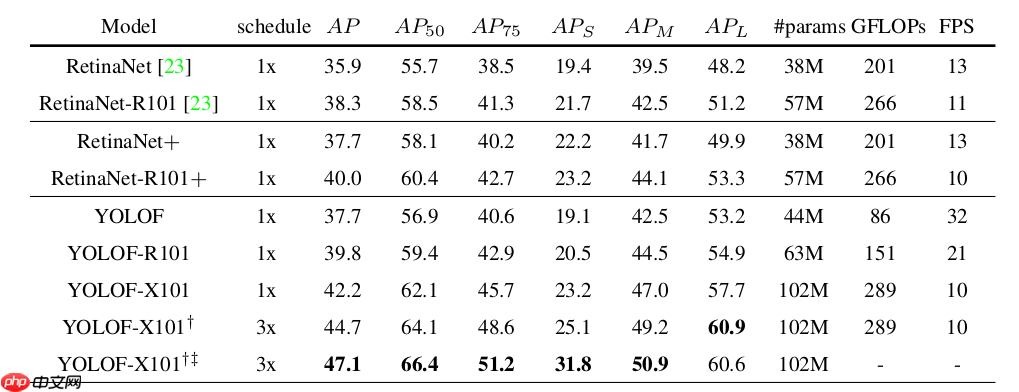
该论文写地很细,读者关心的细节都解释地很清楚,实验也做的很完整,强烈建议大家一读。
官方给出了两个实现版本,一个是基于Detectron2的,一个是基于cvpods的,可以在这里可以找到。其中Detectron2不用过多介绍了,cvpods本人不太熟,貌似是旷世的一个计算机视觉框架。同时MMDetection也对YOLOF进行了实现,并纳入到了他们的检测模型库中。这里我的实现版本主要参照的是MMDetection的实现版本和官方基于Detectron2的版本。
 CodeFormer
是一个基于AI技术的图像修复模型,擅长人脸修复和旧照片清晰化。
 1055
查看详情

我选择基于PaddleDetection进行复现,因为里面集成了很多检测相关组件,可以节省很多时间。而且PaddleDetection官方并没有支持YOLOF,所以是一个很好的炼手机会。其实YOLOF也可以被认为是RetinaNet的一个变种,所以之前复现RetinaNet的经验帮了很大的忙。为了和PaddleDetection风格保持一致,YOLOF的接口设计借鉴了PaddleDetection关于GFL的实现,因为大家都是RetinaNet的变种。要注意的是YOLOF使用的是caffe形式的ResNet,在PaddleDetection下需要把ResNet的variant设置成a。但是PaddleDetection官方并没有提供这个版本的ImageNet预训练权重,所以需要手动转换。我已经将转换好的权重上传到了百度网盘,感兴趣的同学可以前往下载[rpsb]。
当代码敲完,首先在VOC数据上进行训练,调试,直到在VOC上的实现和MMDetection的版本有着差不多的AP之后,再在COCO上进行实验。
| source | backbone | AP | epochs | config | model | train-log | dataset |
|---|---|---|---|---|---|---|---|
| official | R-50-C5 | 37.7 | 12.3(detail) | config | model[qr6o] | NA | coco2017 |
| mmdet | R-50-C5 | 37.5 | 12 | config | model | log | coco2017 |
| this | R-50-C5 | 37.5 | 12 | config | model[3z7q] | log | coco2017 |
| this_re-train | R-50-C5 | 37.4 | 12 | config | model[6faq] | log | coco2017 |
以上是官方的结果和我复现的结果对比,数据集大家采用的都是coco2017,其中模型的训练是在百度的aistudio上完成,使用4张V100显卡,每张显卡上放了8张图片,这个和官方保持一直。这里要特别感谢飞浆团队提供的优质算力。
这里是我复现的代码地址:Paddle-YOLOF,欢迎大家star,上面除了有复现的代码,还有训练好的模型,config和训练过程产生的log。如果有什么疑问可以在issue里提出,我会尽量解答。
安装要求:
去github拉取复现的代码:
git clone https://github.com/thisisi3/Paddle-YOLOF.git
pip install -e Paddle-YOLOF/PaddleDetection -v
访问这个链接了解如何安装PaddleDetection,按照这个链接了解如何使用PaddleDetection.
数据准备:
cd Paddle-YOLOF

wget http://images.cocodataset.org/annotations/annotations_trainval2017.zip
wget http://images.cocodataset.org/zips/train2017.zip
wget http://images.cocodataset.org/zips/val2017.zip

mkdir dataset
mkdir dataset/coco

unzip annotations_trainval2017.zip -d dataset/coco
unzip train2017.zip -d dataset/coco
unzip val2017.zip -d dataset/coco
如果官方的下载比较缓慢,可以访问aistudio下载coco2017数据。
下载backbone的预训练权重:
前往这边[rpsb]下载。然后放在pretrain/目录下。
单卡训练YOLOF:
python PaddleDetection/tools/train.py -c configs/yolof_r50_c5_1x_coco_8x4GPU.yml --eval
4卡训练YOLOF:
python -m paddle.distributed.launch --gpus 0,1,2,3 PaddleDetection/tools/train.py -c configs/yolof_r50_c5_1x_coco_8x4GPU.yml --eval
如果不想在训练的时候计算AP,可以去掉--eval这个选项。
计算AP:
python PaddleDetection/tools/eval.py -c configs/yolof_r50_c5_1x_coco_8x4GPU.yml -o weights=path_to_model_final.pdparams
以上就是基于PPDet的YOLOF模型复现的详细内容,更多请关注其它相关文章!
# git
# python
# 多出
# 一言
# 的是
# 是一个
# 中文网
# coco
# fig
# udio
# igs
# 百度
# 百度网盘
# ai
# 网站首页缩略图seo
# seo 三个标签
# 通化建设网站
# 品牌宣传网站建设范文
# 青娱乐查询seo
# 湖南专业网站优化的价格
# 资阳品牌网站建设方案
# 视频类网站推广
# 长沙seo的缺点
# 谷歌seo引擎
# 所示
# 更快
# 达到了
# 这是
# 都是
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
马斯克“揭秘”人工智能真面目
2025 世界人工智能大会闭幕,32 个重大产业签约总额达 288 亿元
泗洪:畅通城市“血管” ,管下机器人来帮忙
大模型新品出现井喷,AI产业迎来新时代
特斯拉首发人形机器人“擎天柱”亮相世界人工智能大会
优傲机器人的人机协作技术 助力中小企发展
国家发改委组织工业机器人产业高质量发展现场会
优化系统韧性:故障恢复与监控在RabbitMQ中的应用
无人机自主巡检为高海拔输电线路运维添“新彩”
世界周刊丨AI“棱镜”?
找对了风口想不火都难,乐天派机器人,安卓机器人的最终形态?
马斯克回应“人工智能让一切变得更好”:我们已经是半机器人了
AI 大模型重塑软件开发,有哪些落地前景和痛点?| ArchSummit
VR健身应用《FitXR》将取消Quest 1端会员服务
2025世界人工智能大会前沿科技共绘“未来”图景, 这家这家独角兽企业的通用大脑将在AI领域大放异彩
业内领先 四川大学华西第四医院甲状腺乳腺外科成功进入手术机器人时代
智能机器人与话剧的完美结合:宇树四足机器人B1助力《骆驼祥子》重现经典
周鸿祎:360智脑开放API接口 AI大模型将赋能百行千业
酒店业将如何受益于人工智能的改变?
小米创始人雷军将揭示小米AI在年度演讲中的最新进展
“具身智能”引爆机器人产业,看绝影Lite3/X20四足机器人有何特别之处?
给小朋友最好的科技礼物:乐天派桌面机器人
网易易盾 AI Lab 论文入选 ICASSP 2025!黑科技让语音识别越“听”越准
加强高质量数据供应能力,促进通用人工智能大模型领域的创新
为什么很多人对纽约《人工智能招聘法》感到生气?
刊·见 | 捕捉人工智能领域最新动态?收藏Applied Artificial Intelligence
RoboNeo安装教程
WAIC 2025|云深处科技绝影Lite3与X20四足机器人亮相
机构研选 | 虚拟电厂是电力物联网升级版 智能电网望迎来高速发展
联通发布鸿湖图文AI大模型1.0,可实现以文生图
“踩油门,也要会踩刹车” 互联网企业高管谈人工智能发展
今年,全球客服中心支出将增长 16.2%,迎接对话式 AI 的浪潮,根据 Gartner 报告
第四范式「式说」大模型入选《2025年通用人工智能创新应用案例集》
乐天派桌面机器人加入小米米家生态系统,实现与其他智能设备的互联
鉴智机器人发布基于地平线征程5的标准视觉感知产品
AI证件照生成器:实际测试中AI软件展现了绝无仅有的强大效能
磐镭发布全新 GeForce RTX 4080 ARMOUR 显卡,售价为 9499 元
会模仿笔迹的AI,为你创造专属字体
不止“文心一言”,消息称百度将推出全新 AI 对话软件“万话”
行业首发「超级智绘」AI故事集,TCL实业推进AI技术应用
实测 AI 建筑设计软件的自动生成效果图能力
创新科学家成功研发FAST激光靶标维护机器人
电池比 Air 2S 大 20%,大疆 Air 3 无人机现身 FCC
DreamAvatar数字人在哪里下载
对话无界AI创始人长铗:AI的创业机会在应用层丨创新者Innovator
深度学习模型综述:用于3D MRI和CT扫描的应用
论文插图也能自动生成了,用到了扩散模型,还被ICLR接收
人形机器人概念集体爆发,能买吗?
中国移动主导创立元宇宙产业联盟,包括科大讯飞、芒果TV等在内,共24家成员
当一个网站的内容被 AI 完全接管
2025-07-29

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。
