本文围绕模型压缩中的聚类量化展开,先概述模型量化是通过简化参数比特位存储实现压缩。重点介绍Deep Compression的聚类量化思路,包括参数聚类等步骤,还给出用K-Means算法实现聚类量化的代码,搭建网络训练并展示量化前后权重分布及效果,体现聚类量化的作用。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜

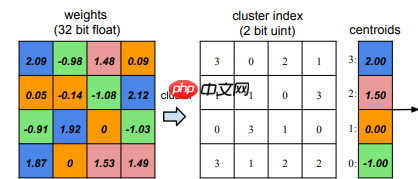
聚类量化实现步骤
Openflow
一键极速绘图,赋能行业工作流
88 查看详情

- 1.进行参数聚类(这种聚类比较特殊,是在一维空间上进行的,能够发现这种分布的不均匀性,也是一种能力)。
- 2.建立位置和类别的映射表。
- 3.将每个类别的数替换为一个数。
- 4.训练模型。
import paddlefrom sklearn.cluster import KMeansIn [33]
# 通过k_means实现对矩阵元素的分类,返回分类后的矩阵和聚类中心def k_means_cpu(weight, n_clusters, init='k-means++', max_iter=50):
    # flatten the weight for computing k-means
    org_shape = weight.shape
    weight = paddle.to_tensor(weight)
    weight = paddle.reshape(weight, [-1, 1])  # single feature
    if n_clusters > weight.size:
        n_clusters = weight.size

    k_means = KMeans(n_clusters=n_clusters, init=init, n_init=1, max_iter=max_iter)
    k_means.fit(weight)

    centroids = k_means.cluster_centers_
    labels = k_means.labels_
    labels = labels.reshape(org_shape)    return paddle.reshape(paddle.to_tensor(centroids), [-1, 1]), paddle.to_tensor(labels, "int32")# 将聚类中心的数值,替换掉分类后矩阵中的类别def reconstruct_weight_from_k_means_result(centroids, labels):
    weight = paddle.zeros_like(labels, "float32")    for i, c in enumerate(centroids.numpy().squeeze()):
        weight[labels == i] = c.item()    return weight
In [3]
# 随机初始个权重w = paddle.rand([4, 5])print(w)
W0127 19:32:47.801596   141 device_context.cc:447] Please NOTE: device: 0, GPU Compute Capability: 7.0, Driver API Version: 11.0, Runtime API Version: 10.1
W0127 19:32:47.808570   141 device_context.cc:465] device: 0, cuDNN Version: 7.6.
Tensor(shape=[4, 5], dtype=float32, place=CUDAPlace(0), stop_gradient=True,
       [[0.76845109, 0.90174955, 0.35342011, 0.94143867, 0.18771467],
        [0.17440563, 0.73438221, 0.36310545, 0.46279457, 0.55644131],
        [0.97877306, 0.35445851, 0.06692132, 0.35885036, 0.06532700],
        [0.39970225, 0.02711770, 0.99831027, 0.43467325, 0.11231221]])
In [69]
# 返回聚类中心centroids,和类别矩阵labelscentroids, labels = k_means_cpu(w, 2)print(centroids)print(labels)
Tensor(shape=[2, 1], dtype=float64, place=CUDAPlace(0), stop_gradient=True,
       [[0.25852331],
        [0.83993517]])
Tensor(shape=[4, 5], dtype=int32, place=CUDAPlace(0), stop_gradient=True,
       [[1, 1, 0, 1, 0],
        [0, 1, 0, 0, 1],
        [1, 0, 0, 0, 0],
        [0, 0, 1, 0, 0]])
In [5]
# reconstruct_weight_from_k_means_result返回聚类后的权重# 将此代码块结果跟上随机初始矩阵、分类矩阵进行比对,发现权重都被聚类中心值替换w_q = reconstruct_weight_from_k_means_result(centroids, labels)print(w_q)
Tensor(shape=[4, 5], dtype=float32, place=CUDAPlace(0), stop_gradient=True,
       [[0.88718414, 0.88718414, 0.27980316, 0.88718414, 0.27980316],
        [0.27980316, 0.88718414, 0.27980316, 0.27980316, 0.27980316],
        [0.88718414, 0.27980316, 0.27980316, 0.27980316, 0.27980316],
        [0.27980316, 0.27980316, 0.88718414, 0.27980316, 0.27980316]])
/opt/conda/envs/python35-paddle120-env/lib/python3.7/site-packages/paddle/fluid/layers/tensor.py:624: UserWarning: paddle.assign doesn't support float64 input now due to current platform protobuf data limitation, we convert it to float32
  "paddle.assign doesn't support float64 input now due "
import paddleimport paddle.nn as nnimport paddle.nn.functional as Ffrom paddle.vision import datasets, transformsimport paddle.utilsimport numpy as npimport mathfrom copy import deepcopyfrom matplotlib import pyplot as pltfrom paddle.io import Datasetfrom paddle.io import DataLoaderfrom sklearn.cluster import KMeans
/opt/conda/envs/python35-paddle120-env/lib/python3.7/site-packages/matplotlib/__init__.py:107: DeprecationWarning: Using or importing the ABCs from 'collections' instead of from 'collections.abc' is deprecated, and in 3.8 it will stop working
  from collections import MutableMapping
/opt/conda/envs/python35-paddle120-env/lib/python3.7/site-packages/matplotlib/rcsetup.py:20: DeprecationWarning: Using or importing the ABCs from 'collections' instead of from 'collections.abc' is deprecated, and in 3.8 it will stop working
  from collections import Iterable, Mapping
/opt/conda/envs/python35-paddle120-env/lib/python3.7/site-packages/matplotlib/colors.py:53: DeprecationWarning: Using or importing the ABCs from 'collections' instead of from 'collections.abc' is deprecated, and in 3.8 it will stop working
  from collections import Sized
In [40]
# 搭建基础线性层class QuantLinear(nn.Linear):
def __init__(self, in_features, out_features, bias=True):
super(QuantLinear, self).__init__(in_features, out_features, bias)
self.weight_labels = None
self.bias_labels = None
self.num_cent = None
self.quant_flag = False
self.quant_bias = False
def kmeans_quant(self, bias=False, quantize_bit=4):
self.num_cent = 2 ** quantize_bit
w = self.weight
centroids, self.weight_labels = k_means_cpu(w.cpu().numpy(), self.num_cent)
w_q = reconstruct_weight_from_k_means_result(centroids, self.weight_labels)
self.weight.set_value(w_q)
if bias:
b = self.bias
centroids, self.bias_labels = k_means_cpu(b.cpu().numpy(), self.num_cent)
b_q = reconstruct_weight_from_k_means_result(centroids, self.bias_labels)
self.bias.data = b_q.float()
self.quant_flag = True
self.quant_bias = bias
def kmeans_update(self):
if not self.quant_flag: return
new_weight_data = paddle.zeros_like(self.weight_labels, "float32") for i in range(self.num_cent):
mask_cl = (self.weight_labels == i).float()
new_weight_data += (self.weight.data * mask_cl).sum() / mask_cl.sum() * mask_cl
self.weight.data = new_weight_data
if self.quant_bias:
new_bias_data = paddle.zeros_like(self.bias_labels, "float32") for i in range(self.num_cent):
mask_cl = (self.bias_labels == i).float()
 new_bias_data += (self.bias.data * mask_cl).sum() / mask_cl.sum() * mask_cl
self.bias.data = new_bias_data
In [39]
# 搭建基础卷积层class QuantConv2d(nn.Conv2D):
    def __init__(self, in_channels, out_channels, kernel_size, stride=1, padding=0, dilation=1,
     groups=1, padding_mode='zeros', weight_attr=None, bias_attr=None, data_format='NCHW'):
        super(QuantConv2d, self).__init__(in_channels, out_channels,
            kernel_size, stride, padding, dilation, groups, padding_mode, weight_attr, bias_attr, data_format)
        self.weight_labels = None
        self.bias_labels = None
        self.num_cent = None
        self.quant_flag = False
        self.quant_bias = False

    def kmeans_quant(self, bias=False, quantize_bit=4):
        self.num_cent = 2 ** quantize_bit

        w = self.weight
        centroids, self.weight_labels = k_means_cpu(w.cpu().numpy(), self.num_cent)
        w_q = reconstruct_weight_from_k_means_result(centroids, self.weight_labels)
        self.weight.set_value(w_q)
        if bias:
            b = self.bias
            centroids, self.bias_labels = k_means_cpu(b.cpu().numpy(), self.num_cent)
            b_q = reconstruct_weight_from_k_means_result(centroids, self.bias_labels)
            self.bias.data = b_q.float()

        self.quant_flag = True
        self.quant_bias = bias
    def kmeans_update(self):
        if not self.quant_flag:            return

        new_weight_data = paddle.zeros_like(self.weight_labels, "float32")        for i in range(self.num_cent):
            mask_cl = (self.weight_labels == i).float()
            new_weight_data += (self.weight.data * mask_cl).sum() / mask_cl.sum() * mask_cl
        self.weight.data = new_weight_data
        if self.quant_bias:
            new_bias_data = paddle.zeros_like(self.bias_labels)            for i in range(self.num_cent):
                mask_cl = (self.bias_labels == i).float()
                new_bias_data += (self.bias.data * mask_cl).sum() / mask_cl.sum() * mask_cl
            self.bias.data = new_bias_data
In [10]
# 搭建网络class ConvNet(nn.Layer):
    def __init__(self):
        super(ConvNet, self).__init__()

        self.conv1 = QuantConv2d(3, 32, kernel_size=3, padding=1, stride=1)
        self.relu1 = nn.ReLU()
        self.maxpool1 = nn.MaxPool2D(2)

        self.conv2 = QuantConv2d(32, 64, kernel_size=3, padding=1, stride=1)
        self.relu2 = nn.ReLU()
        self.maxpool2 = nn.MaxPool2D(2)

        self.conv3 = QuantConv2d(64, 64, kernel_size=3, padding=1, stride=1)
        self.relu3 = nn.ReLU()

        self.linear1 = QuantLinear(7*7*64, 10)
    def forward(self, x):
        out = self.maxpool1(self.relu1(self.conv1(x)))
        out = self.maxpool2(self.relu2(self.conv2(out)))
        out = self.relu3(self.conv3(out))
        out = paddle.reshape(out, [out.shape[0], -1])
        out = self.linear1(out)        return out    def kmeans_quant(self, bias=False, quantize_bit=4):
        # Should be a less manual way to quantize
        # Le*e it for the future
        self.conv1.kmeans_quant(bias, quantize_bit)
        self.conv2.kmeans_quant(bias, quantize_bit)
        self.conv3.kmeans_quant(bias, quantize_bit)
        self.linear1.kmeans_quant(bias, quantize_bit)
    def kmeans_update(self):
        self.conv1.kmeans_update()
        self.conv2.kmeans_update()
        self.conv3.kmeans_update()
        self.linear1.kmeans_update()
In [11]
# 打印输出网络结构convNet_Net = ConvNet()
paddle.summary(convNet_Net,(1, 3, 28, 28))
---------------------------------------------------------------------------
 Layer (type)       Input Shape          Output Shape         Param #
===========================================================================
 QuantConv2d-1    [[1, 3, 28, 28]]     [1, 32, 28, 28]          896
    ReLU-1       [[1, 32, 28, 28]]     [1, 32, 28, 28]           0
  MaxPool2D-1    [[1, 32, 28, 28]]     [1, 32, 14, 14]           0
 QuantConv2d-2   [[1, 32, 14, 14]]     [1, 64, 14, 14]        18,496
    ReLU-2       [[1, 64, 14, 14]]     [1, 64, 14, 14]           0
  MaxPool2D-2    [[1, 64, 14, 14]]      [1, 64, 7, 7]            0
 QuantConv2d-3    [[1, 64, 7, 7]]       [1, 64, 7, 7]         36,928
    ReLU-3        [[1, 64, 7, 7]]       [1, 64, 7, 7]            0
 QuantLinear-1      [[1, 3136]]            [1, 10]            31,370
===========================================================================
Total params: 87,690
Trainable params: 87,690
Non-trainable params: 0
---------------------------------------------------------------------------
Input size (MB): 0.01
Forward/backward pass size (MB): 0.69
Params size (MB): 0.33
Estimated Total Size (MB): 1.04
---------------------------------------------------------------------------
{'total_params': 87690, 'trainable_params': 87690}
In [12]
# 图像转tensor操作,也可以加一些数据增强的方式,例如旋转、模糊等等# 数据增强的方式要加在Compose([  ])中def get_transforms(mode='train'):
    if mode == 'train':
        data_transforms = transforms.Compose([
            transforms.ToTensor(),
            transforms.Normalize(mean=[0.4914, 0.4822, 0.4465], std=[0.2025, 0.1994, 0.2010])])    else:
        data_transforms = transforms.Compose([
            transforms.ToTensor(),
            transforms.Normalize(mean=[0.4914, 0.4822, 0.4465], std=[0.2025, 0.1994, 0.2010])])    return data_transforms# 获取官方MNIST数据集def get_dataset(name='MNIST', mode='train'):
    if name == 'MNIST':
        dataset = datasets.MNIST(mode=mode, transform=get_transforms(mode))    return dataset# 定义数据加载到模型形式def get_dataloader(dataset, batch_size=128, mode='train'):
    dataloader = DataLoader(dataset, batch_size=batch_size, num_workers=2, shuffle=(mode == 'train'))    return dataloader
In [13]
# 初始化函数,用于模型初始化class AverageMeter():
    """ Meter for monitoring losses"""
    def __init__(self):
        self.*g = 0
        self.sum = 0
        self.cnt = 0
        self.reset()    def reset(self):
        """reset all values to zeros"""
        self.*g = 0
        self.sum = 0
        self.cnt = 0

    def update(self, val, n=1):
        """update *g by val and n, where val is the *g of n values"""
        self.sum += val * n
        self.cnt += n
        self.*g = self.sum / self.cnt
In [15]
# 网络训练def train_one_epoch(model, dataloader, criterion, optimizer, epoch, total_epoch, report_freq=20):
    print(f'----- Training Epoch [{epoch}/{total_epoch}]:')
    loss_meter = AverageMeter()
    acc_meter = AverageMeter()
    model.train()    for batch_idx, data in enumerate(dataloader):
        image = data[0]
        label = data[1]

        out = model(image)
        loss = criterion(out, label)

        loss.backward()
        optimizer.step()
        optimizer.clear_grad()

        pred = nn.functional.softmax(out, axis=1)
        acc1 = paddle.metric.accuracy(pred, label)

        batch_size = image.shape[0]
        loss_meter.update(loss.cpu().numpy()[0], batch_size)
        acc_meter.update(acc1.cpu().numpy()[0], batch_size)        if batch_idx > 0 and batch_idx % report_freq == 0:            print(f'----- Batch[{batch_idx}/{len(dataloader)}], Loss: {loss_meter.*g:.5}, Acc@1: {acc_meter.*g:.4}')    print(f'----- Epoch[{epoch}/{total_epoch}], Loss: {loss_meter.*g:.5}, Acc@1: {acc_meter.*g:.4}')
In [25]
# 网络预测def validate(model, dataloader, criterion, report_freq=10):
    print('----- Validation')
    loss_meter = AverageMeter()
    acc_meter = AverageMeter()
    model.eval()    for batch_idx, data in enumerate(dataloader):
        image = data[0]
        label = data[1]

        out = model(image)
        loss = criterion(out, label)

        pred = paddle.nn.functional.softmax(out, axis=1)
        acc1 = paddle.metric.accuracy(pred, label)
        batch_size = image.shape[0]
        loss_meter.update(loss.cpu().numpy()[0], batch_size)
        acc_meter.update(acc1.cpu().numpy()[0], batch_size)        if batch_idx > 0 and batch_idx % report_freq == 0:            print(f'----- Batch [{batch_idx}/{len(dataloader)}], Loss: {loss_meter.*g:.5}, Acc@1: {acc_meter.*g:.4}')    print(f'----- Validation Loss: {loss_meter.*g:.5}, Acc@1: {acc_meter.*g:.4}')
In [64]
def main():
    total_epoch = 1
    batch_size = 256

    model = ConvNet()
    train_dataset = get_dataset(mode='train')
    train_dataloader = get_dataloader(train_dataset, batch_size, mode='train')
    val_dataset = get_dataset(mode='test')
    val_dataloader = get_dataloader(val_dataset, batch_size, mode='test')
    criterion = nn.CrossEntropyLoss()
    scheduler = paddle.optimizer.lr.CosineAnnealingDecay(0.02, total_epoch)
    optimizer = paddle.optimizer.Momentum(learning_rate=scheduler,
                                          parameters=model.parameters(),
                                          momentum=0.9,
                                          weight_decay=5e-4)

    eval_mode = False
    if eval_mode:
        state_dict = paddle.load('./ConvNet_ep200.pdparams')
        model.set_state_dict(state_dict)
        validate(model, val_dataloader, criterion)        return


    s*e_freq = 50
    test_freq = 10
    for epoch in range(1, total_epoch+1):
        train_one_epoch(model, train_dataloader, criterion, optimizer, epoch, total_epoch)
        scheduler.step()        if epoch % test_freq == 0 or epoch == total_epoch:
            validate(model, val_dataloader, criterion)        if epoch % s*e_freq == 0 or epoch == total_epoch:
            paddle.s*e(model.state_dict(), f'./ConvNet_ep{epoch}.pdparams')
            paddle.s*e(optimizer.state_dict(), f'./ConvNet_ep{epoch}.pdopts')

    quant_model = deepcopy(model)    print('=='*10)    print('2 bits quantization')
    quant_model.kmeans_quant(bias=False, quantize_bit=4)
    validate(quant_model, val_dataloader, criterion)    return model, quant_model
In [65]
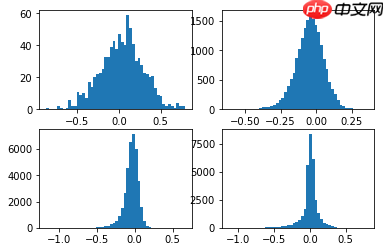
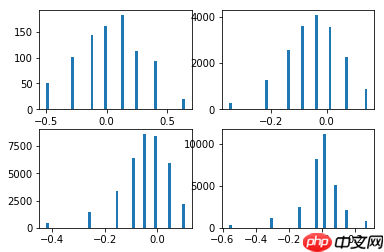
# 返回值是量化前后网络模型# main()中quantize_bit控制聚类个数,聚类为quantize_bit*2个# 聚类数越多,量化后的模型越接近训练模型,但参数相应增加,所以根据实际情况取舍model, quant_model = main()In [60]
from matplotlib import pyplot as pltIn [61]
# 定义模型权重展示函数def plot_weights(model):
    modules = [module for module in model.sublayers()]
    num_sub_plot = 0
    for i, layer in enumerate(modules):        if hasattr(layer, 'weight'):
            plt.subplot(221+num_sub_plot)
            w = layer.weight
            w_one_dim = w.cpu().numpy().flatten()
            plt.hist(w_one_dim, bins=50)
            num_sub_plot += 1
    plt.show()
In [66]
# 量化前的权重plot_weights(model)
<Figure size 432x288 with 4 Axes>In [67]
# 量化后的权重plot_weights(quant_model)
<Figure size 432x288 with 4 Axes>
以上就是模型压缩之聚类量化的详细内容,更多请关注其它相关文章!
# ai
# python
# 甘肃网络营销推广策略
# 淘宝关键词排名走势
# 摆设海淘网站怎么做推广
# 中国香港网站建设企业
# 做网址seo的步骤
# 阿里妈妈网站推广申请
# 济南网络seo
# 竞价推广网站空间
# 汾阳互联网网站推广
# 河南企业抖音seo教程
# 解决问题
# 相关文章
# 是指
# 工作流
# 浮点
# 如下图
# 官网
# 类中
# 一言
# 中文网
# type
# fig
# latte
# red
# cos
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
刊·见 | 捕捉人工智能领域最新动态?收藏Applied Artificial Intelligence
利好来了,AI再起一波?
LinkedIn 推出生成式 AI 辅助撰写帖文功能,将向所有用户开放
美的推出 AI 双视精准避障的自动集尘扫拖机器人 V12,售价仅为2999元
AI和ML推动联网设备的增长
Stability AI 推出文生图模型 SDXL0.9,GPU要求下探至消费级水平
研究表明 GPT-4 模型具备自我纠错能力,有望推动 AI 代码进一步商业化
人工智能时代的科幻译者怎么办?“做好翻译工作的高端10%”|文化观察
Meta推出VR订阅服务Quest +:每月免费玩两款游戏,7.99美元/月
Dubbo负载均衡策略之 一致性哈希
OpenAI高管:AI能创造新的就业机会 但也会淘汰一些
如布科技发布新产品AI口袋学习机S12
真全息产品,亮相深圳文博会——dipal数伴拓展元宇宙非沉浸式体验
谷歌StyleDrop在可控性上卷翻MidJourney,前GitHub CTO用AI颠覆编程
首届亚太网络法实务大会召开 九位大咖探讨元宇宙与人工智能发展
可按用户语气自动回复消息,Zoom 推出基于生成式 AI 的新功能
视觉中国宣布推出AI灵感绘图、画面扩展功能
布局智能物联新时代,中国移动“5G+物联网”亮相2025 MWC
甲骨文与Cohere合作为企业提供生成式人工智能服务
AI大模型,将为智慧城市带来哪些新变化?
Meta发布音频AI模型,仅需2秒片段模拟真人语音
7大探索区域打造沉浸式玩乐“元宇宙” 昆明京东MALL未来科技探索官全城招募中
旷视入选北京市通用人工智能产业创新伙伴计划
PS AI修图免费平替来了!Stability AI又放大招,核弹级更新一键扩图
苹果在韩举办首届中小企业智能制造论坛,加速推动工业4.0发展
OpenAI CEO 山姆・阿尔特曼呼吁 AI 领域中美应当合作
DeepMind推惊世排序算法,C++库忙更新!
650亿参数,8块GPU就能全参数微调:邱锡鹏团队把大模型门槛打下来了
研究发现AI聊天机器人ChatGPT不会讲笑话,只会重复25个老梗
消息称 ChatGPT 未来有望增加更多功能:上传文件分析信息,还能记住用户画像
构建AI绘画网站的方法:使用API接口和调用步骤
Databricks 发布大数据分析平台 Spark 用 AI 模型 SDK:一键生成 SQL 及 FySpark 语言图表代码
当一切设备都受到人工智能的控制
一家 380 亿美元的数据巨头,要掀起企业「AI 化」革命
盘古大模型3.0正式发布 AI开发正走向新“工业化开发模式”
马斯克回应“人工智能让一切变得更好”:我们已经是半机器人了
AI 模型 Stable Diffusion 升级:正常生成五指、图像更逼真
扎克伯格吐槽苹果Vision Pro:社交落后Meta太多,无法建设元宇宙
AI大模型产品集体奔赴高考考场,教育赛道的讯飞星火能赢吗?
科普:什么是AI大模型
比尔盖茨:AI确实存在风险,但可控
腾讯汤道生:大模型只是起点,产业落地是AI更大的应用场景
RoboNeo安装教程
实践J*a开发,构建高性能的MongoDB数据迁移工具
加州用AI监测野火:1032个摄像头联网扫描森林异常
SnapFusion技术大幅提升AI图像生成速度
了解 AGI:智能的未来?
Unity 内测 Safe Voice 服务,利用 AI 自动识别玩家不当聊天内容
微软大牛加入ZOOM,AI人才大战打响
埃森哲俞毅:AI时代我们需要新的“摩尔定律”
2025-07-31

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。

 new_bias_data += (self.bias.data * mask_cl).sum() / mask_cl.sum() * mask_cl
self.bias.data = new_bias_data