本项目旨在借助神经网络技术构建教师课堂情绪识别系统,以提升教学质量。数据集含7种人脸表情的jpg图片,训练集28204张、测试集7054张。通过数据预处理、搭建RepVGG模型、训练及预测等步骤,实现对教师情绪的识别,进而辅助调整教学策略。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜

一键运行
在现代教育体系中,教学质量是教师和学生共同关注的核心议题。教师作为知识的传授者和课堂的主导者,其情绪状态不仅直接影响到自身的教学热情和动力,更对学生的学习态度、课堂氛围以及最终的教学效果产生深远影响。然而,传统的教学评估方式往往侧重于知识传授的效果和学生的学习成绩,而忽视了教师在教学过程中的情绪变化及其对教学质量的潜在影响。
近年来,随着人工智能技术的飞速发展,特别是神经网络技术在图像识别、自然语言处理等领域的广泛应用,为教育领域带来了前所未有的变革机遇。神经网络技术以其强大的数据处理能力和模式识别能力,为教育数据的深度挖掘和智能分析提供了强有力的技术支持。在此背景下,开发一种能够实时、准确地识别教师课堂情绪状态的智能系统显得尤为重要。
Openflow
一键极速绘图,赋能行业工作流
88 查看详情

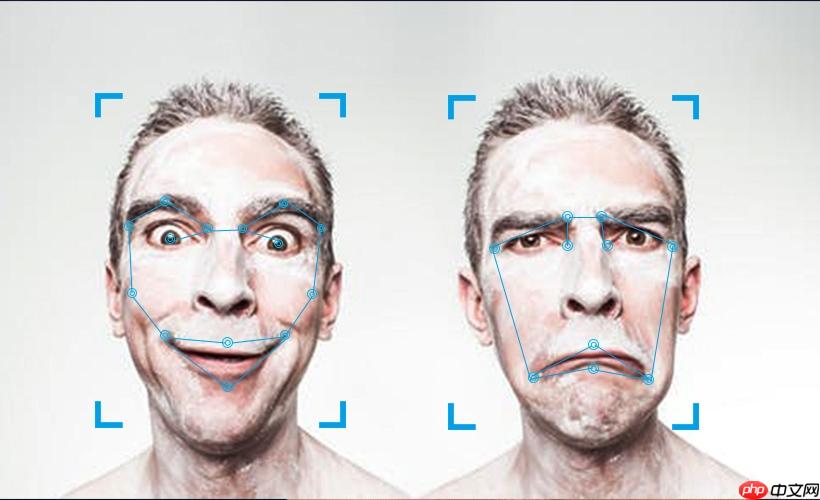
本项目旨在通过运用先进的神经网络技术,构建一套“教师课堂情绪识别系统”。该系统能够自动捕捉并分析教师的面部表情特征,实时识别出教师的情绪状态(如高兴、平静、沮丧等),并基于这些情绪状态为教师提供个性化的教学策略调整建议。通过这样的智能辅助工具,教师可以更加直观地了解自己在课堂上的情绪表现,及时发现问题并进行调整,从而提升自身的教学能力,营造更加积极、高效的课堂氛围,最终实现教学质量的全面提升。
%%capture
!unzip  /home/aistudio/data/data293196/expression.zip -d /home/aistudio/
import paddlefrom paddle.vision.datasets import DatasetFolderfrom paddle.vision import transforms# 定义训练集的数据增强和数据处理方式train_transform=transforms.Compose([transforms.ColorJitter(brightness=0.2),
                                    transforms.Resize(128),
                                    transforms.RandomHorizontalFlip(prob=0.5),
                                    transforms.RandomRotation(degrees=7),
                                    transforms.ToTensor(data_format='CHW'),
                                    transforms.Normalize(mean=0.0, std=1.0, data_format='CHW')])
train_dataset=DatasetFolder(root="/home/aistudio/expression/train",transform=train_transform)# 定义测试集的数据处理方test_transform=transforms.Compose([transforms.Resize(128),
                                   transforms.ToTensor(data_format='CHW'),
                                   transforms.Normalize(mean=0.0, std=1.0, data_format='CHW')])
test_dataset=DatasetFolder(root="/home/aistudio/expression/test",transform=test_transform)print(f"训练集共有图片:{train_dataset.__len__()}张")print(f"测试集共有图片:{test_dataset.__len__()}张")print(f"总计有图片:{train_dataset.__len__()+test_dataset.__len__()}张")
训练集共有图片:28204张
测试集共有图片:7054张
总计有图片:35258张
import paddleimport paddle.nn as nnfrom paddle.optimizer.lr import CosineAnnealingDecayfrom paddle.optimizer import AdamWIn [7]
import warnings
warnings.filterwarnings("ignore")def conv_bn(in_channels, out_channels, kernel_size, stride, padding, groups=1):
result = paddle.nn.Sequential(
('conv',nn.Conv2D(in_channels=in_channels, out_channels=out_channels,kernel_size=kernel_size, stride=stride, padding=padding, groups=groups, bias_attr=False)),
('bn',nn.BatchNorm2D(num_features=out_channels))
) return result# 构建RepVGGBlock模块class RepVGGBlock(nn.Layer):
def __init__(self, in_channels, out_channels, kernel_size,
stride=1, padding=0, dilation=1, groups=1, padding_mode='zeros', deploy=False):
super(RepVGGBlock, self).__init__()
self.deploy = deploy # deploy是推理部署的意思
self.groups = groups # 输入的特征层分为几组,这是分组卷积概念,单卡GPU不用考虑,默认为1,分组卷积概念详见下面
self.in_channels = in_channels # 输入通道
assert kernel_size == 3
assert padding == 1 # 为什么这么设置呢,图像padding=1后经过 3x3 卷积之后图像大小不变
padding_11 = padding - kernel_size // 2
self.nonlinearity = nn.ReLU() if deploy:
self.rbr_reparam = nn.Conv2D(in_channels=in_channels, out_channels=out_channels, kernel_size=kernel_size, stride=stride,
padding=padding, dilation=dilation, groups=groups, bias_attr=True, padding_mode=padding_mode) # 定义推理模型时,基本block就是一个简单的 conv2D
else:
self.rbr_identity = nn.BatchNorm2D(num_features=in_channels) if out_channels == in_channels and stride == 1 else None
# 直接连接,类似resnet残差连接,注意当输入通道和输出通道不同时候,只有 1x1 和 3x3 卷积,没有identity,下面网络图自己体会
self.rbr_dense = conv_bn(in_channels=in_channels, out_channels=out_channels, kernel_size=kernel_size, stride=stride, padding=padding, groups=groups) #3x3卷积+BN
self.rbr_1x1 = conv_bn(in_channels=in_channels, out_channels=out_channels, kernel_size=1, stride=stride, padding=padding_11, groups=groups) #1x1卷积+BN
def forward(self, inputs):
if hasattr(self, 'rbr_reparam'): return self.nonlinearity(self.rbr_reparam(inputs)) # 推理阶段, conv2D 后 ReLU
if self.rbr_identity is None:
id_out = 0
else:
id_out = self.rbr_identity(inputs) return self.nonlinearity(self.rbr_dense(inputs) + self.rbr_1x1(inputs) + id_out) # 训练阶段,3x3、1x1、identity 相加后 ReLU
def get_equivalent_kernel_bias(self):
kernel3x3, bias3x3 = self._fuse_bn_tensor(self.rbr_dense) # 卷积核两个参数 W 和 b 提出来
kernel1x1, bias1x1 = self._fuse_bn_tensor(self.rbr_1x1)
kernelid, biasid = self._fuse_bn_tensor(self.rbr_identity) # 为啥可以提出两个参数,看论文公式
return kernel3x3 + self._pad_1x1_to_3x3_tensor(kernel1x1) + kernelid, bias3x3 + bias1x1 + biasid
def _pad_1x1_to_3x3_tensor(self, kernel1x1):
if kernel1x1 is None: return 0
else: return nn.functional.pad(kernel1x1, [1,1,1,1]) def _fuse_bn_tensor(self, branch):
if branch is None: return 0, 0
# 当branch不是3x3、1x1、BN,那就返回 W=0, b=0
if isinstance(branch, nn.Sequential):
kernel = branch.conv.weight # conv权重
running_mean = branch.bn._mean # BN mean
running_var = branch.bn._variance # BN var
gamma = branch.bn.weight # BN γ
beta = branch.bn.bias # BN β
eps = branch.bn._epsilon # 防止分母为0
# 当branch是3x3、1x1时候,返回以上数据,为后面做融合
else: assert isinstance(branch, nn.BatchNorm2D) if not hasattr(self, 'id_tensor'):
input_dim = self.in_channels // self.groups # 通道分组,单个GPU不用考虑,详情去搜索分组卷积
kernel_value = np.zeros((self.in_channels, input_dim, 3, 3), dtype=np.float32) # 定义新的3x3卷积核,参数为0,这里 用到DepthWise,详情去搜索MobileNetV1
# 这部分看后面讲解
for i in range(self.in_channels):
kernel_value[i, i % input_dim, 1, 1] = 1 # 将卷积核对角线部分赋予1
self.id_tensor = paddle.to_tensor(kernel_value)
kernel = self.id_tensor # conv权重
running_mean = branch._mean # BN mean
running_var = branch._variance # BN var
gamma = branch.weight # BN γ
beta = branch.bias # BN β
eps = branch._epsilon # 防止分母为0
std = (running_var + eps).sqrt()
t = (gamma / std).reshape((-1, 1, 1, 1)) return kernel * t, beta - running_mean * gamma / std def repvgg_convert(self):
kernel, bias = self.get_equivalent_kernel_bias() return kernel.numpy(), bias.numpy()# 构建RepVGGBlock模块class RepVGGBlock(nn.Layer):
def __init__(self, in_channels, out_channels, kernel_size,
stride=1, padding=0, dilation=1, groups=1, padding_mode='zeros', deploy=False):
super(RepVGGBlock, self).__init__()
self.deploy = deploy # deploy是推理部署的意思
self.groups = groups # 输入的特征层分为几组,这是分组卷积概念,单卡GPU不用考虑,默认为1,分组卷积概念详见下面
self.in_channels = in_channels # 输入通道
assert kernel_size == 3
assert padding == 1 # 为什么这么设置呢,图像padding=1后经过 3x3 卷积之后图像大小不变
padding_11 = padding - kernel_size // 2
self.nonlinearity = nn.ReLU() if deploy:
self.rbr_reparam = nn.Conv2D(in_channels=in_channels, out_channels=out_channels, kernel_size=kernel_size, stride=stride,
padding=padding, dilation=dilation, groups=groups, bias_attr=True, padding_mode=padding_mode) # 定义推理模型时,基本block就是一个简单的 conv2D
else:
self.rbr_identity = nn.BatchNorm2D(num_features=in_channels) if out_channels == in_channels and stride == 1 else None
# 直接连接,类似resnet残差连接,注意当输入通道和输出通道不同时候,只有 1x1 和 3x3 卷积,没有identity,下面网络图自己体会
self.rbr_dense = conv_bn(in_channels=in_channels, out_channels=out_channels, kernel_size=kernel_size, stride=stride, padding=padding, groups=groups) #3x3卷积+BN
self.rbr_1x1 = conv_bn(in_channels=in_channels, out_channels=out_channels, kernel_size=1, stride=stride, padding=padding_11, groups=groups) #1x1卷积+BN
def forward(self, inputs):
if hasattr(self, 'rbr_reparam'): return self.nonlinearity(self.rbr_reparam(inputs)) # 推理阶段, conv2D 后 ReLU
if self.rbr_identity is None:
id_out = 0
else:
id_out = self.rbr_identity(inputs) return self.nonlinearity(self.rbr_dense(inputs) + self.rbr_1x1(inputs) + id_out) # 训练阶段,3x3、1x1、identity 相加后 ReLU
def get_equivalent_kernel_bias(self):
kernel3x3, bias3x3 = self._fuse_bn_tensor(self.rbr_dense) # 卷积核两个参数 W 和 b 提出来
kernel1x1, bias1x1 = self._fuse_bn_tensor(self.rbr_1x1)
kernelid, biasid = self._fuse_bn_tensor(self.rbr_identity) # 为啥可以提出两个参数,看论文公式
return kernel3x3 + self._pad_1x1_to_3x3_tensor(kernel1x1) + kernelid, bias3x3 + bias1x1 + biasid
def _pad_1x1_to_3x3_tensor(self, kernel1x1):
if kernel1x1 is None: return 0
else: return nn.functional.pad(kernel1x1, [1,1,1,1]) def _fuse_bn_tensor(self, branch):
if branch is None: return 0, 0
# 当branch不是3x3、1x1、BN,那就返回 W=0, b=0
if isinstance(branch, nn.Sequential):
kernel = branch.conv.weight # conv权重
running_mean = branch.bn._mean # BN mean
running_var = branch.bn._variance # BN var
gamma = branch.bn.weight # BN γ
beta = branch.bn.bias # BN β
eps = branch.bn._epsilon # 防止分母为0
# 当branch是3x3、1x1时候,返回以上数据,为后面做融合
else: assert isinstance(branch, nn.BatchNorm2D) if not hasattr(self, 'id_tensor'):
input_dim = self.in_channels // self.groups # 通道分组,单个GPU不用考虑,详情去搜索分组卷积
kernel_value = np.zeros((self.in_channels, input_dim, 3, 3), dtype=np.float32) # 定义新的3x3卷积核,参数为0,这里用到DepthWise,详情去搜索MobileNetV1
# 这部分看后面讲解
for i in range(self.in_channels):
kernel_value[i, i % input_dim, 1, 1] = 1 # 将卷积核对角线部分赋予1
self.id_tensor = paddle.to_tensor(kernel_value)
kernel = self.id_tensor # conv权重
running_mean = branch._mean # BN mean
running_var = branch._variance # BN var
gamma = branch.weight # BN γ
beta = branch.bias # BN β
eps = branch._epsilon # 防止分母为0
# 当branch是 identity,也即只有BN时候返回以上数据
std = (running_var + eps).sqrt()
t = (gamma / std).reshape((-1, 1, 1, 1)) # 提取W、b,不管你是 3x3 1x1 identity都要提取
return kernel * t, beta - running_mean * gamma / std def repvgg_convert(self):
kernel, bias = self.get_equivalent_kernel_bias() return kernel.numpy(), bias.numpy()class RepVGG(nn.Layer):
def __init__(self, num_blocks, num_classes=1000, width_multiplier=None, override_groups_map=None, deploy=False):
super(RepVGG, self).__init__() assert len(width_multiplier) == 4 # 江湖人称瘦身因子,减小网络的宽度,就是输出通道乘以权重变小还是变大
self.deploy = deploy
self.override_groups_map = override_groups_map or dict() # 这部分是分组卷积,单个GPU不用考虑
assert 0 not in self.override_groups_map
self.in_planes = min(64, int(64 * width_multiplier[0]))
self.stage0 = RepVGGBlock(in_channels=3, out_channels=self.in_planes, kernel_size=3, stride=2, padding=1, deploy=self.deploy)
self.cur_layer_idx = 1 # 分组卷积
self.stage1 = self._make_stage(int(64 * width_multiplier[0]), num_blocks[0], stride=2)
self.stage2 = self._make_stage(int(128 * width_multiplier[1]), num_blocks[1], stride=2)
self.stage3 = self._make_stage(int(256 * width_multiplier[2]), num_blocks[2], stride=2)
self.stage4 = self._make_stage(int(512 * width_multiplier[3]), num_blocks[3], stride=2)
self.gap = nn.AdaptiveAvgPool2D(output_size=1) # 全局池化,变成 Nx1x1(CxHxW),类似 flatten
self.linear = nn.Linear(int(512 * width_multiplier[3]), num_classes)
def _make_stage(self, planes, num_blocks, stride):
strides = [stride] + [1]*(num_blocks-1)
blocks = [] for stride in strides:
cur_groups = self.override_groups_map.get(self.cur_layer_idx, 1) # 分组卷积
blocks.append(RepVGGBlock(in_channels=self.in_planes, out_channels=planes, kernel_size=3,
stride=stride, padding=1, groups=cur_groups, deploy=self.deploy))
self.in_planes = planes
self.cur_layer_idx += 1
return nn.Sequential(*blocks) def forward(self, x):
out = self.stage0(x)
out = self.stage1(out)
out = self.stage2(out)
out = self.stage3(out)
out = self.stage4(out)
out = self.gap(out)
out = paddle.flatten(out,start_axis=1)
out = self.linear(out) return outdef create_RepVGG_B2(deploy=False,num_classes=7):
return RepVGG(num_blocks=[4, 6, 16, 1], num_classes=num_classes,
width_multiplier=[2.5, 2.5, 2.5, 5], override_groups_map=None, deploy=deploy)
model=create_RepVGG_B2(num_classes=7)
In [12]
import warnings
warnings.filterwarnings("ignore")
paddle.jit.s*e(model, '/home/aistudio/work/repvgg', [paddle.static.InputSpec([-1,3,128,128])])
model=paddle.Model(model)
scheduler = CosineAnnealingDecay(
    learning_rate=0.01,
    T_max=80,
)                            # 定义学习率衰减器opti = AdamW(
    learning_rate=scheduler,
    parameters=model.parameters(),
    weight_decay=1e-5)                            # 定义Adam优化器model.prepare(optimizer=opti,loss=paddle.nn.CrossEntropyLoss(), metrics=paddle.metric.Accuracy())
In [ ]
callback = paddle.callbacks.VisualDL(log_dir='work/log_dir')

model.fit(train_data=train_dataset,     # 指定训练集
            eval_data=test_dataset,     # 指定验证集
            batch_size=256,             # 一次性读取样本数
            epochs=80,                 # 总共训练的轮数
            eval_freq=1,                # 每隔1轮测试一次
            verbose=1,                  # 输出级别
            s*e_dir="work/output/",         # 权重等文件保存地址
            num_workers=6,              # 多线程用于加快数据读取
            callbacks=[callback])       # 将VisualDL指定进去
model=create_RepVGG_B2(num_classes=7)In [23]
import cv2import paddlefrom paddle.vision import transformsimport matplotlib.pyplot as plt

label={0:'anger',1:'disgust',2:'fear',3:'happy',4:'sad',5:'surprised',6:'normal'}# 加载训练好的权重文件,该网络已经具备表情识别的能力best_model_path = "/home/aistudio/work/output/final.pdparams"para_state_dict = paddle.load(best_model_path)
model.eval() # 测试时要设置eval模式model.set_state_dict(para_state_dict)# 加载一张图片并进行预处理img=cv2.imread("/home/aistudio/2.png")
img=cv2.cvtColor(img,cv2.COLOR_BGR2RGB)     # cv2默认是BGR模式img=cv2.resize(img,(128,128))
input_tensor=transforms.to_tensor(img, data_format='CHW')       # 转为paddle.tensor类型input_tensor=paddle.unsqueeze(input_tensor,axis=0)  #因为输出shape应为(b,c,h,w),而现在是(c,h,w),所以升维变成(1,c,h,w)从而符合模型的输入格式# 推理图片获取识别结果test_result = model(input_tensor)   # 输出会给出7个类的概率值,而最大值所在的类就是预测结果max_prob_index=paddle.argmax(test_result[0])# 展示图片和预测结果plt.figure()
plt.title('predict: {}'.format(label[int(max_prob_index)]))
plt.imshow(img)
plt.show()
<Figure size 640x480 with 1 Axes>
以上就是教师情绪智能识别——调整教学策略,提高教学质量!【一键运行】的详细内容,更多请关注其它相关文章!
# 数据处理
# 滕州seo优化推广软件
# 网站建设步骤列表图片
# 关键词排名优化投放咨询
# 烟台知名网站建设
# 铅球教案网站建设
# 新乡网站推广费用
# 滨江企业网站优化
# 越秀区网站建设定制公司
# 谷歌seo外包商
# 灯饰推广怎么做好营销
# 种人
# 衰减器
# 那就
# 这是
# 工具
# 这部
# 教学质量
# 提高教学质量
# 中文网
# 一键
# type
# fig
# latte
# udio
# red
# 为什么
# cos
# ai
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
全场景智能车:智能无处不在|芯驰亮相世界人工智能大会
标贝科技亮相国际顶会ICASSP2025 加速布局海外AI数据市场
再也不怕「视频会议」尬住了!谷歌CHI顶会发布新神器Visual Captions:让图片做你的字幕助手
美图公司:Wink国内首发AI画面拓展功能
智能技术提高现代商业运营的7七种方式
梦想实现!硬核科幻大片VR智能头盔即将问世
苹果AI战略与微软谷歌大相径庭,到底是领先还是落后?
机构研选 | 虚拟电厂是电力物联网升级版 智能电网望迎来高速发展
无需标注数据,「3D理解」进入多模态预训练时代!ULIP系列全面开源,刷新SOTA
朝鲜出现国产大型察打一体无人机,实力世界第二,太意外了
苹果2万5的AR遭遇砍单95%:不及预期
【|直播|预告】人工智能高峰论坛将于7月2日13:30准时开播!
剧透!蜜小豆@2025世界人工智能大会多个亮点曝光
华为AI大模型将融入HarmonyOS 4
QQ音乐业内率先推出「AI一起听」功能,领取你的AI听歌助手
创新全场景清洁方案!海尔商用机器人首发上市
智能电网技术:提高能源效率和可靠性
调研海尔智家:AI名,家电命?
“五年内人类程序员将消失”预言引争议,AI真的那么强大了吗?
利好来了,AI再起一波?
AI工具助力公司实施每周4.5天工作制,带来巨大效益
科技数码圈的新物种 乐天派桌面机器人 AI +安卓+机器人 首发价1799元
码刻 | 48小时Hackathon,源码见证新生代AI创新的发生
网易云音乐内测上线“私人DJ” 打造AI推荐音乐助手
三个全球首创,青岛西海岸新区“海元宇宙”亮相世界人工智能大会
遵义市首次引入手术机器人,成功实施全膝关节置换术
普渡机器人与变形金刚品牌合作,特别活动爆火,商品售罄!
鸿蒙4即将支持大规模AI模型
携程发布旅游行业垂直大模型 梁建章:AI策略是做可靠的内容 放心的推荐
【澎湃原动力】人工智能产业协同创新中心:全产业链资源在这里汇聚
马斯克反讽人工智能AI炒作:“机器学习”本质就是统计
腾讯企点客服接待与营销分析能力升级!企业操作更高效、人机交互更智能
2025年深圳举办的SUSECON 创新峰会开始接受报名
IBM 与 NASA 携手开源地理空间 AI 模型,促进气候科学研究进步
微幼科技推出全自动晨检机器人,助力幼儿园校园健康检测
Xreal AR 眼镜用投屏盒子 Beam 发布:分体式设计,到手 699 元
IBM将模拟计算用于人工智能,重塑AI计算
OpenAI更新GPT-4等模型,新增API函数调用,价格最高降75%
马斯克回应“人工智能让一切变得更好”:我们已经是半机器人了
一文看懂基础模型的定义和工作原理
大型无人机FH-98国内首次夜航转场成功
美的推出 AI 双视精准避障的自动集尘扫拖机器人 V12,售价仅为2999元
小米发布CyberDog2 - 他们的第二代仿生四足机器人展示
工业机器人及非标自动化设备集成服务提供商
美图公司吴欣鸿:AI技术重构影像产业
再度重仓 AI 赛道,SaaS 巨头 Salesforce 扩大 AIGC 风投基金规模
掌阅科技申请阅爱聊商标 掌阅科技申请AI相关商标
英伟达推出 L40S GPU,AI 推理性能超过 A100 约 1.2 倍
人工智能在项目管理中的作用
V社回应拒绝上架含 AI 生成内容的游戏:审核政策正在调整中
2025-07-31

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。

 用到DepthWise,详情去搜索MobileNetV1
# 这部分看后面讲解
for i in range(self.in_channels):
kernel_value[i, i % input_dim, 1, 1] = 1 # 将卷积核对角线部分赋予1
self.id_tensor = paddle.to_tensor(kernel_value)
kernel = self.id_tensor # conv权重
running_mean = branch._mean # BN mean
running_var = branch._variance # BN var
gamma = branch.weight # BN γ
beta = branch.bias # BN β
eps = branch._epsilon # 防止分母为0
std = (running_var + eps).sqrt()
t = (gamma / std).reshape((-1, 1, 1, 1)) return kernel * t, beta - running_mean * gamma / std def repvgg_convert(self):
kernel, bias = self.get_equivalent_kernel_bias() return kernel.numpy(), bias.numpy()# 构建RepVGGBlock模块class RepVGGBlock(nn.Layer):
def __init__(self, in_channels, out_channels, kernel_size,
stride=1, padding=0, dilation=1, groups=1, padding_mode='zeros', deploy=False):
super(RepVGGBlock, self).__init__()
self.deploy = deploy # deploy是推理部署的意思
self.groups = groups # 输入的特征层分为几组,这是分组卷积概念,单卡GPU不用考虑,默认为1,分组卷积概念详见下面
self.in_channels = in_channels # 输入通道
assert kernel_size == 3
assert padding == 1 # 为什么这么设置呢,图像padding=1后经过 3x3 卷积之后图像大小不变
padding_11 = padding - kernel_size // 2
self.nonlinearity = nn.ReLU() if deploy:
self.rbr_reparam = nn.Conv2D(in_channels=in_channels, out_channels=out_channels, kernel_size=kernel_size, stride=stride,
padding=padding, dilation=dilation, groups=groups, bias_attr=True, padding_mode=padding_mode) # 定义推理模型时,基本block就是一个简单的 conv2D
else:
self.rbr_identity = nn.BatchNorm2D(num_features=in_channels) if out_channels == in_channels and stride == 1 else None
# 直接连接,类似resnet残差连接,注意当输入通道和输出通道不同时候,只有 1x1 和 3x3 卷积,没有identity,下面网络图自己体会
self.rbr_dense = conv_bn(in_channels=in_channels, out_channels=out_channels, kernel_size=kernel_size, stride=stride, padding=padding, groups=groups) #3x3卷积+BN
self.rbr_1x1 = conv_bn(in_channels=in_channels, out_channels=out_channels, kernel_size=1, stride=stride, padding=padding_11, groups=groups) #1x1卷积+BN
def forward(self, inputs):
if hasattr(self, 'rbr_reparam'): return self.nonlinearity(self.rbr_reparam(inputs)) # 推理阶段, conv2D 后 ReLU
if self.rbr_identity is None:
id_out = 0
else:
id_out = self.rbr_identity(inputs) return self.nonlinearity(self.rbr_dense(inputs) + self.rbr_1x1(inputs) + id_out) # 训练阶段,3x3、1x1、identity 相加后 ReLU
def get_equivalent_kernel_bias(self):
kernel3x3, bias3x3 = self._fuse_bn_tensor(self.rbr_dense) # 卷积核两个参数 W 和 b 提出来
kernel1x1, bias1x1 = self._fuse_bn_tensor(self.rbr_1x1)
kernelid, biasid = self._fuse_bn_tensor(self.rbr_identity) # 为啥可以提出两个参数,看论文公式
return kernel3x3 + self._pad_1x1_to_3x3_tensor(kernel1x1) + kernelid, bias3x3 + bias1x1 + biasid
def _pad_1x1_to_3x3_tensor(self, kernel1x1):
if kernel1x1 is None: return 0
else: return nn.functional.pad(kernel1x1, [1,1,1,1]) def _fuse_bn_tensor(self, branch):
if branch is None: return 0, 0
# 当branch不是3x3、1x1、BN,那就返回 W=0, b=0
if isinstance(branch, nn.Sequential):
kernel = branch.conv.weight # conv权重
running_mean = branch.bn._mean # BN mean
running_var = branch.bn._variance # BN var
gamma = branch.bn.weight # BN γ
beta = branch.bn.bias # BN β
eps = branch.bn._epsilon # 防止分母为0
# 当branch是3x3、1x1时候,返回以上数据,为后面做融合
else: assert isinstance(branch, nn.BatchNorm2D) if not hasattr(self, 'id_tensor'):
input_dim = self.in_channels // self.groups # 通道分组,单个GPU不用考虑,详情去搜索分组卷积
kernel_value = np.zeros((self.in_channels, input_dim, 3, 3), dtype=np.float32) # 定义新的3x3卷积核,参数为0,这里用到DepthWise,详情去搜索MobileNetV1
# 这部分看后面讲解
for i in range(self.in_channels):
kernel_value[i, i % input_dim, 1, 1] = 1 # 将卷积核对角线部分赋予1
self.id_tensor = paddle.to_tensor(kernel_value)
kernel = self.id_tensor # conv权重
running_mean = branch._mean # BN mean
running_var = branch._variance # BN var
gamma = branch.weight # BN γ
beta = branch.bias # BN β
eps = branch._epsilon # 防止分母为0
# 当branch是 identity,也即只有BN时候返回以上数据
std = (running_var + eps).sqrt()
t = (gamma / std).reshape((-1, 1, 1, 1)) # 提取W、b,不管你是 3x3 1x1 identity都要提取
return kernel * t, beta - running_mean * gamma / std def repvgg_convert(self):
kernel, bias = self.get_equivalent_kernel_bias() return kernel.numpy(), bias.numpy()class RepVGG(nn.Layer):
def __init__(self, num_blocks, num_classes=1000, width_multiplier=None, override_groups_map=None, deploy=False):
super(RepVGG, self).__init__() assert len(width_multiplier) == 4 # 江湖人称瘦身因子,减小网络的宽度,就是输出通道乘以权重变小还是变大
self.deploy = deploy
self.override_groups_map = override_groups_map or dict() # 这部分是分组卷积,单个GPU不用考虑
assert 0 not in self.override_groups_map
self.in_planes = min(64, int(64 * width_multiplier[0]))
self.stage0 = RepVGGBlock(in_channels=3, out_channels=self.in_planes, kernel_size=3, stride=2, padding=1, deploy=self.deploy)
self.cur_layer_idx = 1 # 分组卷积
self.stage1 = self._make_stage(int(64 * width_multiplier[0]), num_blocks[0], stride=2)
self.stage2 = self._make_stage(int(128 * width_multiplier[1]), num_blocks[1], stride=2)
self.stage3 = self._make_stage(int(256 * width_multiplier[2]), num_blocks[2], stride=2)
self.stage4 = self._make_stage(int(512 * width_multiplier[3]), num_blocks[3], stride=2)
self.gap = nn.AdaptiveAvgPool2D(output_size=1) # 全局池化,变成 Nx1x1(CxHxW),类似 flatten
self.linear = nn.Linear(int(512 * width_multiplier[3]), num_classes)
def _make_stage(self, planes, num_blocks, stride):
strides = [stride] + [1]*(num_blocks-1)
blocks = [] for stride in strides:
cur_groups = self.override_groups_map.get(self.cur_layer_idx, 1) # 分组卷积
blocks.append(RepVGGBlock(in_channels=self.in_planes, out_channels=planes, kernel_size=3,
stride=stride, padding=1, groups=cur_groups, deploy=self.deploy))
self.in_planes = planes
self.cur_layer_idx += 1
return nn.Sequential(*blocks) def forward(self, x):
out = self.stage0(x)
out = self.stage1(out)
out = self.stage2(out)
out = self.stage3(out)
out = self.stage4(out)
out = self.gap(out)
out = paddle.flatten(out,start_axis=1)
out = self.linear(out) return outdef create_RepVGG_B2(deploy=False,num_classes=7):
return RepVGG(num_blocks=[4, 6, 16, 1], num_classes=num_classes,
width_multiplier=[2.5, 2.5, 2.5, 5], override_groups_map=None, deploy=deploy)
model=create_RepVGG_B2(num_classes=7)